Übersetzungsanbieter
Der AI Localization Automator unterstützt fünf verschiedene AI-Anbieter, die jeweils einzigartige Stärken und Konfigurationsoptionen bieten. Wählen Sie den Anbieter, der am besten zu den Anforderungen, dem Budget und den Qualitätsanforderungen Ihres Projekts passt.
Ollama (Lokale AI)
Am besten geeignet für: Datenschutzsensible Projekte, Offline-Übersetzung, unbegrenzte Nutzung
Ollama führt KI-Modelle lokal auf Ihrem Rechner aus und bietet vollständige Privatsphäre und Kontrolle ohne API-Kosten oder Internetanforderungen.
Beliebte Modelle
- translategemma:12b (Spezialisiertes Übersetzungsmodell basierend auf Gemma 3)
- llama3.2 (Empfohlen für allgemeine Zwecke)
- mistral (Effiziente Alternative)
- codellama (Code-bewusste Übersetzungen)
- Und viele weitere Community-Modelle
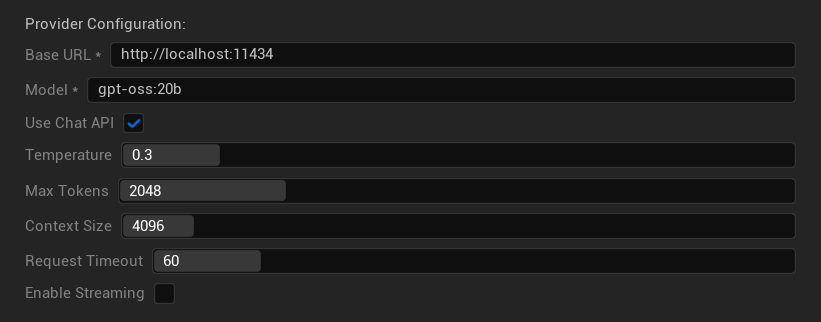
Konfigurationsoptionen
- Basis-URL: Lokaler Ollama-Server (Standard:
http://localhost:11434) - Modell: Name des lokal installierten Modells (erforderlich)
- Chat-API verwenden: Aktivieren für bessere Gesprächsverarbeitung
- Temperatur: 0,0–2,0 (0,3 empfohlen)
- Maximale Tokens: 1–8.192 Token
- Kontextgröße: 512–32.768 Token
- Anfrage-Timeout: 10–300 Sekunden (lokale Modelle können langsamer sein)
- Streaming aktivieren: Für Echtzeit-Antwortverarbeitung
Stärken
- ✅ Vollständige Privatsphäre (keine Daten verlassen Ihren Rechner)
- ✅ Keine API-Kosten oder Nutzungsbeschränkungen
- ✅ Funktioniert offline
- ✅ Vollständige Kontrolle über Modellparameter
- ✅ Große Auswahl an Community-Modellen
- ✅ Keine Anbieterbindung
Überlegungen
- 💻 Erfordert lokale Einrichtung und leistungsfähige Hardware
- ⚡ In der Regel langsamer als Cloud-Anbieter
- 🔧 Erfordert technischere Einrichtung
- 📊 Die Übersetzungsqualität variiert stark je nach Modell (einige können Cloud-Anbieter übertreffen)
- 💾 Große Speicheranforderungen für Modelle
Ollama einrichten
- Ollama installieren: Laden Sie es von ollama.ai herunter und installieren Sie es auf Ihrem System
- Modelle herunterladen: Verwenden Sie
ollama pull translategemma:12b, um Ihr ausgewähltes Modell herunterzuladen - Server starten: Ollama läuft automatisch, oder starten Sie es mit
ollama serve - Plugin konfigurieren: Legen Sie die Basis-URL und den Modellnamen in den Plugin-Einstellungen fest
- Verbindung testen: Das Plugin überprüft die Konnektivität, wenn Sie die Konfiguration anwenden
OpenAI
Am besten geeignet für: Höchste Gesamtübersetzungsqualität, umfangreiche Modellauswahl
OpenAI bietet branchenführende Sprachmodelle über ihre Chat Completions API, einschließlich der neuesten GPT-Modelle, Schlussfolgerungsmodelle und websuchfähige Modelle.
Verfügbare Modelle
GPT-5-Familie (Flaggschiffmodelle)
- gpt-5, gpt-5-mini, gpt-5-nano
- gpt-5.1, gpt-5.2, gpt-5.3-chat-latest
- gpt-5.4, gpt-5.4-mini, gpt-5.4-nano
- gpt-5.5, gpt-5.6-sol, gpt-5.6-luna
GPT-4.1 Familie (Hochleistungsfähig)
- gpt-4.1, gpt-4.1-mini, gpt-4.1-nano
GPT-4o Family (Multimodal)
- gpt-4o, gpt-4o-mini, chatgpt-4o-latest
O-Series (Reasoning-Modelle — temperature/top_p nicht unterstützt)
- o1, o1-pro, o3, o3-mini, o4-mini
Web-Suchmodelle (Temperature/top_p nicht unterstützt)
- gpt-5-search-api, gpt-4o-search-preview, gpt-4o-mini-search-preview
Legacy / Vorschau
- gpt-4.5-preview, gpt-4, gpt-4-32k, gpt-4-turbo, gpt-3.5-turbo, gpt-3.5-turbo-16k
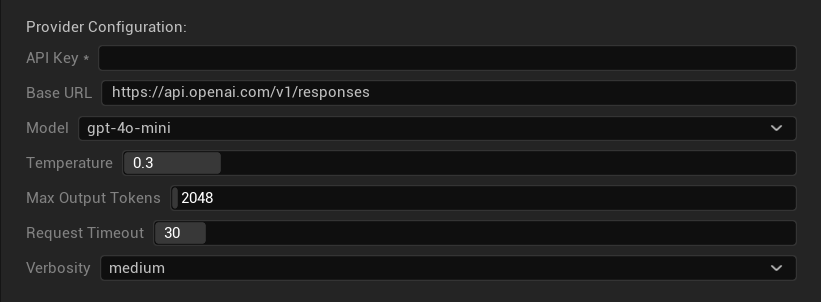
Konfigurationsoptionen
- API-Key: Ihr OpenAI-API-Key (erforderlich)
- Basis-URL: API-Endpunkt (Standard:
https://api.openai.com/v1/chat/completions) - Modell: Wählen Sie aus den oben aufgeführten verfügbaren Modellen
- Temperatur verwenden: Temperaturparameter ein-/ausschalten (wird bei o-Serie-Überlegungsmodellen und Websuchmodellen automatisch ignoriert)
- Temperatur: 0,0–2,0 (0,3 für Übersetzungskonsistenz empfohlen)
- Top P: 0,0–1,0 Nucleus-Sampling-Parameter (wird bei o-Serie-Überlegungsmodellen und Websuchmodellen ignoriert)
- Max. Abschluss-Tokens: 1–128.000 Tokens (umfasst sowohl Ausgabe- als auch Überlegungs-Tokens)
- Anfrage-Timeout: 5–300 Sekunden
Stärken
- ✅ Konstant hochwertige Übersetzungen
- ✅ Hervorragendes Kontextverständnis
- ✅ Starke Formatierungserhaltung
- ✅ Breite Sprachunterstützung
- ✅ Zuverlässige API-Verfügbarkeit
Überlegungen
- 💰 Höhere Kosten pro Anfrage
- 🌐 Erfordert Internetverbindung
- ⏱️ Nutzungslimits basierend auf der Stufe
Anthropic Claude
Ideal für: nuancenreiche Übersetzungen, kreative Inhalte, sicherheitsorientierte Anwendungen
Claude-Modelle zeichnen sich durch das Verständnis von Kontext und Nuancen aus, was sie ideal für erzähllastige Spiele und komplexe Lokalisierungsszenarien macht.
Verfügbare Modelle
Claude 5 Familie
- claude-opus-5, claude-sonnet-5, claude-fable-5
Claude 4.8 Familie
- claude-opus-4-8
Claude 4.7 Family
- claude-opus-4-7
Claude 4.6 Family
- claude-opus-4-6, claude-sonnet-4-6
Claude 4.5 Familie
- claude-haiku-4-5 (Schnell und effizient)
- claude-sonnet-4-5, claude-opus-4-5
Claude 4.x Familie
- claude-sonnet-4-0, claude-opus-4-1, claude-opus-4-0
Claude 3.x Familie (Veraltet)
- claude-3-7-sonnet-latest, claude-3-5-haiku-latest, claude-3-opus-latest
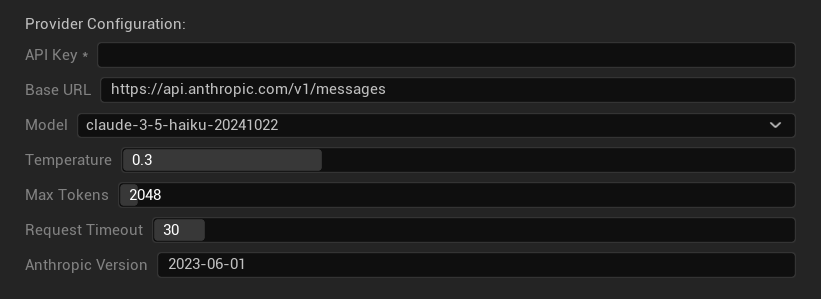
Konfigurationsoptionen
- API-Schlüssel: Ihr Anthropic-API-Schlüssel (erforderlich)
- Basis-URL: Claude-API-Endpunkt
- Modell: Auswählen aus der Claude-Modellfamilie
- Temperatur: 0,0–1,0 (0,3 empfohlen)
- Top-K: Top-K-Sampling-Parameter (0 = nicht gesetzt)
- Max. Tokens: 1–64.000 Tokens
- Anfrage-Timeout: 5–300 Sekunden
- Anthropic-Version: API-Versionsheader
Stärken
- ✅ Außergewöhnliches Kontextbewusstsein
- ✅ Großartig für kreative/narrative Inhalte
- ✅ Starke Sicherheitsfunktionen
- ✅ Detaillierte Argumentationsfähigkeiten (erweitertes Denken bei 3.7+ Modellen)
- ✅ Hervorragende Befolgung von Anweisungen
Überlegungen
- 💰 Premium-Preismodell
- 🌐 Internetverbindung erforderlich
- 📏 Tokengrenzen variieren je nach Modell
DeepSeek
Am besten geeignet für: Kosteneffiziente Übersetzung, hoher Durchsatz, budgetbewusste Projekte
DeepSeek bietet eine wettbewerbsfähige Übersetzungsqualität zu einem Bruchteil der Kosten anderer Anbieter, was es ideal für groß angelegte Lokalisierungsprojekte macht.
Verfügbare Modelle
- deepseek-v4-pro
- deepseek-v4-flash
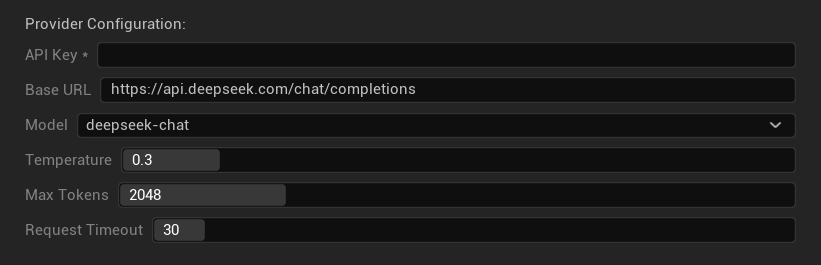
Konfigurationsoptionen
- API-Schlüssel: Ihr DeepSeek-API-Schlüssel (erforderlich)
- Basis-URL: DeepSeek-API-Endpunkt
- Modell: Wählen Sie zwischen Chat- und Reasoner-Modellen
- Temperatur: 0,0-2,0 (0,3 empfohlen)
- Maximale Token-Anzahl: 1–8.192 Token
- Anfrage-Timeout: 5–300 Sekunden
Stärken
- ✅ Sehr kosteneffizient
- ✅ Gute Übersetzungsqualität
- ✅ Schnelle Antwortzeiten
- ✅ Einfache Konfiguration
- ✅ Hohe Ratenlimits
Überlegungen
- 📏 Niedrigere Token-Limits
- 🆕 Neuerer Anbieter (weniger Erfahrung)
- 🌐 Erfordert Internetverbindung
Google Gemini
Am besten geeignet für: Mehrsprachige Projekte, kosteneffiziente Übersetzung, Integration in das Google-Ökosystem
Gemini-Modelle bieten starke mehrsprachige Fähigkeiten zu wettbewerbsfähigen Preisen und einzigartige Funktionen wie den Denkmodus für verbesserte Argumentation.
Verfügbare Modelle
Gemini 3.x Familie (Vorschau)
- gemini-3.1-pro, gemini-3.1-flash-light, gemini-3.5-flash, gemini-3.6-flash
Gemini 2.5 Family (mit Denkunterstützung)
- gemini-2.5-pro (Flaggschiff mit Denkfähigkeit)
- gemini-2.5-flash (Schnell, mit Denkunterstützung)
- gemini-2.5-flash-lite (Leichte Variante)
Gemini 2.0 Familie
- gemini-2.0-flash, gemini-2.0-flash-lite
Neueste Aliase
- gemini-flash-latest, gemini-flash-lite-latest
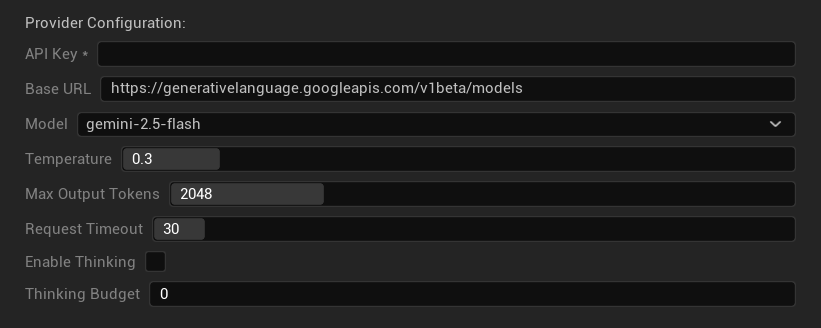
Konfigurationsoptionen
- API-Schlüssel: Ihr Google AI-API-Schlüssel (erforderlich)
- Basis-URL: Gemini-API-Endpunkt
- Modell: Aus der Gemini-Modellfamilie auswählen
- Temperatur: 0,0–2,0 (0,3 empfohlen)
- Maximale Ausgabe-Token: 1–8.192 Token
- Anfrage-Timeout: 5–300 Sekunden
- Denken aktivieren: Erhöhtes Reasoning für 2.5+-Modelle aktivieren
- Denk-Budget: Zuweisung von Denk-Token steuern (0 = kein Denken)
Stärken
- ✅ Starke mehrsprachige Unterstützung
- ✅ Wettbewerbsfähige Preise
- ✅ Erweiterte Argumentation (Denkmodus)
- ✅ Integration in das Google-Ökosystem
- ✅ Regelmäßige Modellaktualisierungen mit Vorabzugriff auf die neuesten Modelle
Überlegungen
- 🧠 Denkmodus erhöht den Token-Verbrauch
- 📏 Variable Token-Limits je nach Modell
- 🌐 Internetverbindung erforderlich
Auswahl des richtigen Anbieters
| Anbieter | Am besten geeignet für | Qualität | Cost | Einrichtung | Datenschutz |
|---|---|---|---|---|---|
| Ollama | Datenschutz/Offline | Variable* | Free | Erweitert | Lokal |
| OpenAI | Höchste Qualität | ⭐⭐⭐⭐⭐ | 💰💰💰 | Easy | Cloud |
| Claude | Kreative Inhalte | ⭐⭐⭐⭐⭐ | 💰💰💰💰 | Easy | Cloud |
| DeepSeek | Budget-Projekte | ⭐⭐⭐⭐ | 💰 | Easy | Cloud |
| Gemini | Mehrsprachig | ⭐⭐⭐⭐ | 💰 | Easy | Cloud |
*Qualität für Ollama variiert erheblich je nach verwendetem lokalen Modell – einige moderne lokale Modelle können mit Cloud-Anbietern mithalten oder sie übertreffen.
Tipps zur Anbieterkonfiguration
Für alle Cloud-Anbieter:
- Speichern Sie API-Schlüssel sicher und übergeben Sie sie nicht an die Versionskontrolle
- Beginnen Sie mit konservativen Temperatureinstellungen (0,3) für konsistente Übersetzungen
- Überwachen Sie Ihre API-Nutzung und -Kosten
- Testen Sie mit kleinen Stapeln, bevor Sie große Übersetzungsläufe durchführen
Für Ollama:
- Sorgen Sie für ausreichend RAM (8 GB+ empfohlen für größere Modelle)
- Verwenden Sie SSD-Speicher für eine bessere Modellladeleistung
- Ziehen Sie GPU-Beschleunigung für schnellere Inferenz in Betracht
- Testen Sie lokal, bevor Sie sich für Produktionsübersetzungen darauf verlassen