Plugin-Konfiguration
Modellkonfiguration
Für einen zuverlässigen Betrieb mit den Modellen Realistic und Mood-Enabled Realistic sollte der Generator vor jeder neuen Audiowiedergabe neu erstellt werden, anstatt einen über lange Stillephasen hinweg wiederzuverwenden. Weitere Details finden Sie unter Generator Recreation in der Fehlerbehebung.
Standardmodell-Konfiguration
Der Node Create Runtime Viseme Generator verwendet Standardeinstellungen, die für die meisten Szenarien gut funktionieren. Die Konfiguration erfolgt über die Eigenschaften des Animation Blueprint-Blending-Nodes.
Für Konfigurationsoptionen des Animation Blueprint siehe den Abschnitt Lip Sync-Konfiguration unten.
Realistische Modellkonfiguration
Der Node Create Realistic MetaHuman Lip Sync Generator akzeptiert einen optionalen Parameter Configuration, mit dem du das Verhalten des Generators anpassen kannst:
Modelltyp
Die Einstellung Model Type bestimmt, welche Version des realistischen Modells verwendet wird:
| Modelltyp | Leistung | Visuelle Qualität | Rauschunterdrückung | Empfohlene Anwendungsfälle |
|---|---|---|---|---|
| Hoch optimiert (Standard) | Höchste Leistung, geringste CPU-Auslastung | Gute Qualität | Kann bei Hintergrundgeräuschen oder Nicht-Sprachgeräuschen deutliche Mundbewegungen zeigen | Saubere Audioumgebungen, leistungskritische Szenarien |
| Semi-optimiert | Gute Leistung, moderate CPU-Auslastung | Hohe Qualität | Bessere Stabilität bei verrauschtem Audio | Ausgewogene Leistung und Qualität, gemischte Audio-Bedingungen |
| Original | Geeignet für den Echtzeiteinsatz auf modernen CPUs | Höchste Qualität | Am stabilsten bei Hintergrundgeräuschen und Nicht-Sprachgeräuschen | Hochwertige Produktionen, verrauschte Audioumgebungen, wenn maximale Genauigkeit erforderlich ist |
Leistungseinstellungen
Intra-Op-Threads: Steuert die Anzahl der Threads, die für interne Modellverarbeitungsvorgänge verwendet werden.
- 0 (Standard/Automatisch): Verwendet automatische Erkennung (typischerweise 1/4 der verfügbaren CPU-Kerne, maximal 4)
- 1-16: Thread-Anzahl manuell festlegen. Höhere Werte können die Leistung auf Multi-Core-Systemen verbessern, verbrauchen aber mehr CPU
Inter-Op-Threads: Steuert die Anzahl der Threads, die für die parallele Ausführung verschiedener Modelloperationen verwendet werden.
- 0 (Standard/Automatisch): Verwendet automatische Erkennung (typischerweise 1/8 der verfügbaren CPU-Kerne, maximal 2)
- 1-8: Thread-Anzahl manuell angeben. Wird normalerweise für Echtzeitverarbeitung niedrig gehalten
Verarbeitung der Chunk-Größe
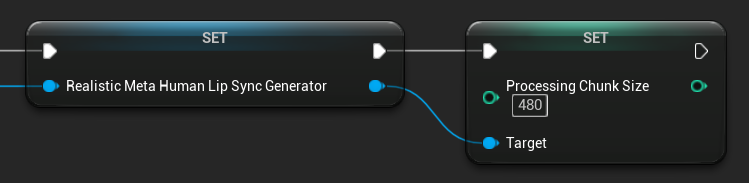
Die Processing Chunk Size bestimmt, wie viele Samples in jedem Inferenzschritt verarbeitet werden. Der Standardwert ist 160 Samples (10 ms Audio bei 16 kHz):
- Kleinere Werte sorgen für häufigere Aktualisierungen, erhöhen aber die CPU-Auslastung
- Größere Werte reduzieren die CPU-Last, können aber die Reaktionsfähigkeit des Lip Sync verringern
- Es wird empfohlen, Vielfache von 160 für eine optimale Ausrichtung zu verwenden
Stimmungsaktivierte Modellkonfiguration
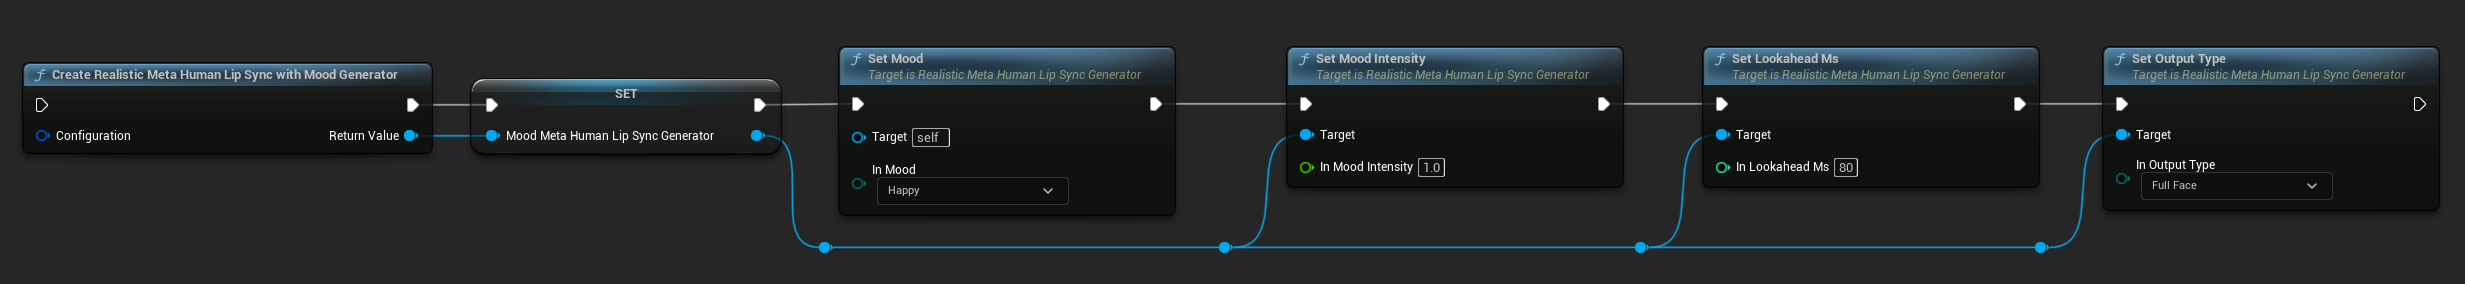
Der Node Create Realistic MetaHuman Lip Sync With Mood Generator bietet zusätzliche Konfigurationsoptionen über das grundlegende realistische Modell hinaus:
Grundlegende Konfiguration
Lookahead Ms: Vorlaufzeit in Millisekunden für eine verbesserte Lip-Sync-Genauigkeit.
- Standard: 80ms
- Bereich: 20ms bis 200ms (muss durch 20 teilbar sein)
- Höhere Werte bieten eine bessere Synchronisierung, erhöhen jedoch die Latenz
Ausgabetyp: Steuert, welche Gesichtssteuerungen generiert werden.
- Volles Gesicht: Alle 81 Gesichtssteuerungen (Augenbrauen, Augen, Nase, Mund, Kiefer, Zunge)
- Nur Mund: Nur mund-, kiefer- und zungenbezogene Steuerungen
Leistungseinstellungen: Verwendet dieselben Einstellungen für Intra Op Threads und Inter Op Threads wie das reguläre realistische Modell.
Stimmungseinstellungen
Verfügbare Stimmungen:
- Neutral, Fröhlich, Traurig, Ekel, Wut, Überraschung, Angst
- Selbstbewusst, Aufgeregt, Gelangweilt, Verspielt, Verwirrt
Stimmungsintensität: Steuert, wie stark sich die Stimmung auf die Animation auswirkt (0.0 bis 1.0)
Laufzeit-Stimmungssteuerung
Sie können die Stimmungseinstellungen zur Laufzeit mit den folgenden Funktionen anpassen:
- Stimmung festlegen: Ändert den aktuellen Stimmungstyp
- Stimmungsintensität festlegen: Passt an, wie stark die Stimmung die Animation beeinflusst (0.0 bis 1.0)
- Lookahead Ms festlegen: Ändert das Lookahead-Timing für die Synchronisierung
- Ausgabetyp festlegen: Wechselt zwischen Vollgesicht- und Nur-Mund-Steuerung
Leitfaden zur Stimmungsauswahl
Wählen Sie passende Stimmungen basierend auf Ihrem Inhalt aus:
| Mood | Am besten geeignet für | Typischer Intensitätsbereich |
|---|---|---|
| Neutral | Allgemeine Konversation, Erzählung, Standardzustand | 0.5 - 1.0 |
| Fröhlich | Positive Inhalte, fröhlicher Dialog, Feiern | 0.6 - 1.0 |
| Traurig | Melancholische Inhalte, emotionale Szenen, düstere Momente | 0.5 - 0.9 |
| Ekel | Negative Reaktionen, abstoßende Inhalte, Ablehnung | 0.4 - 0.8 |
| Wut | Aggressiver Dialog, konfrontative Szenen, Frustration | 0.6 - 1.0 |
| Überraschung | Unerwartete Ereignisse, Enthüllungen, Schockreaktionen | 0.7 - 1.0 |
| Angst | Bedrohliche Situationen, Angstzustände, nervöser Dialog | 0.5 - 0.9 |
| Selbstbewusst | Professionelle Präsentationen, Führungsdialog, durchsetzungsfähige Sprache | 0.7 - 1.0 |
| Begeistert | Energiegeladene Inhalte, Ankündigungen, begeisterter Dialog | 0.8 - 1.0 |
| Gelangweilt | Monotone Inhalte, desinteressierter Dialog, müde Sprache | 0.3 - 0.7 |
| Verspielt | Lässige Konversation, Humor, unbeschwerte Interaktionen | 0.6 - 0.9 |
| Verwirrt | Fragenlastiger Dialog, Unsicherheit, Verwirrung | 0.4 - 0.8 |
Animation Blueprint-Konfiguration
Lip-Sync-Konfiguration
- Standardmodell
- Realistische Modelle
Der Blend Runtime MetaHuman Lip Sync-Node hat Konfigurationsoptionen in seinem Eigenschaftenpanel:
| Eigenschaft | Standard | Beschreibung |
|---|---|---|
| Interpolationsgeschwindigkeit | 25 | Steuert, wie schnell die Lippenbewegungen zwischen den Visemen wechseln. Höhere Werte führen zu schnelleren, abrupteren Übergängen. |
| Zurücksetzzeit | 0.2 | Die Dauer in Sekunden, nach der der Lip Sync zurückgesetzt wird. Dies ist nützlich, um zu verhindern, dass der Lip Sync fortgesetzt wird, nachdem das Audio gestoppt wurde. |
Lachanimation
Du kannst auch Lachanimationen hinzufügen, die dynamisch auf im Audio erkanntes Lachen reagieren:
- Füge den Node
Blend Runtime MetaHuman Laughterhinzu - Verbinde deine Variable
RuntimeVisemeGeneratormit dem PinViseme Generator - Wenn du bereits Lip Sync verwendest:
- Verbinde die Ausgabe des
Blend Runtime MetaHuman Lip Sync-Nodes mit derSource PosedesBlend Runtime MetaHuman Laughter-Nodes - Verbinde die Ausgabe des
Blend Runtime MetaHuman Laughter-Nodes mit demResult-Pin derOutput Pose
- Verbinde die Ausgabe des
- Wenn nur Lachen ohne Lip Sync verwendet wird:
- Verbinde deine Quell-Pose direkt mit der
Source PosedesBlend Runtime MetaHuman Laughter-Nodes - Verbinde die Ausgabe mit dem
Result-Pin
- Verbinde deine Quell-Pose direkt mit der
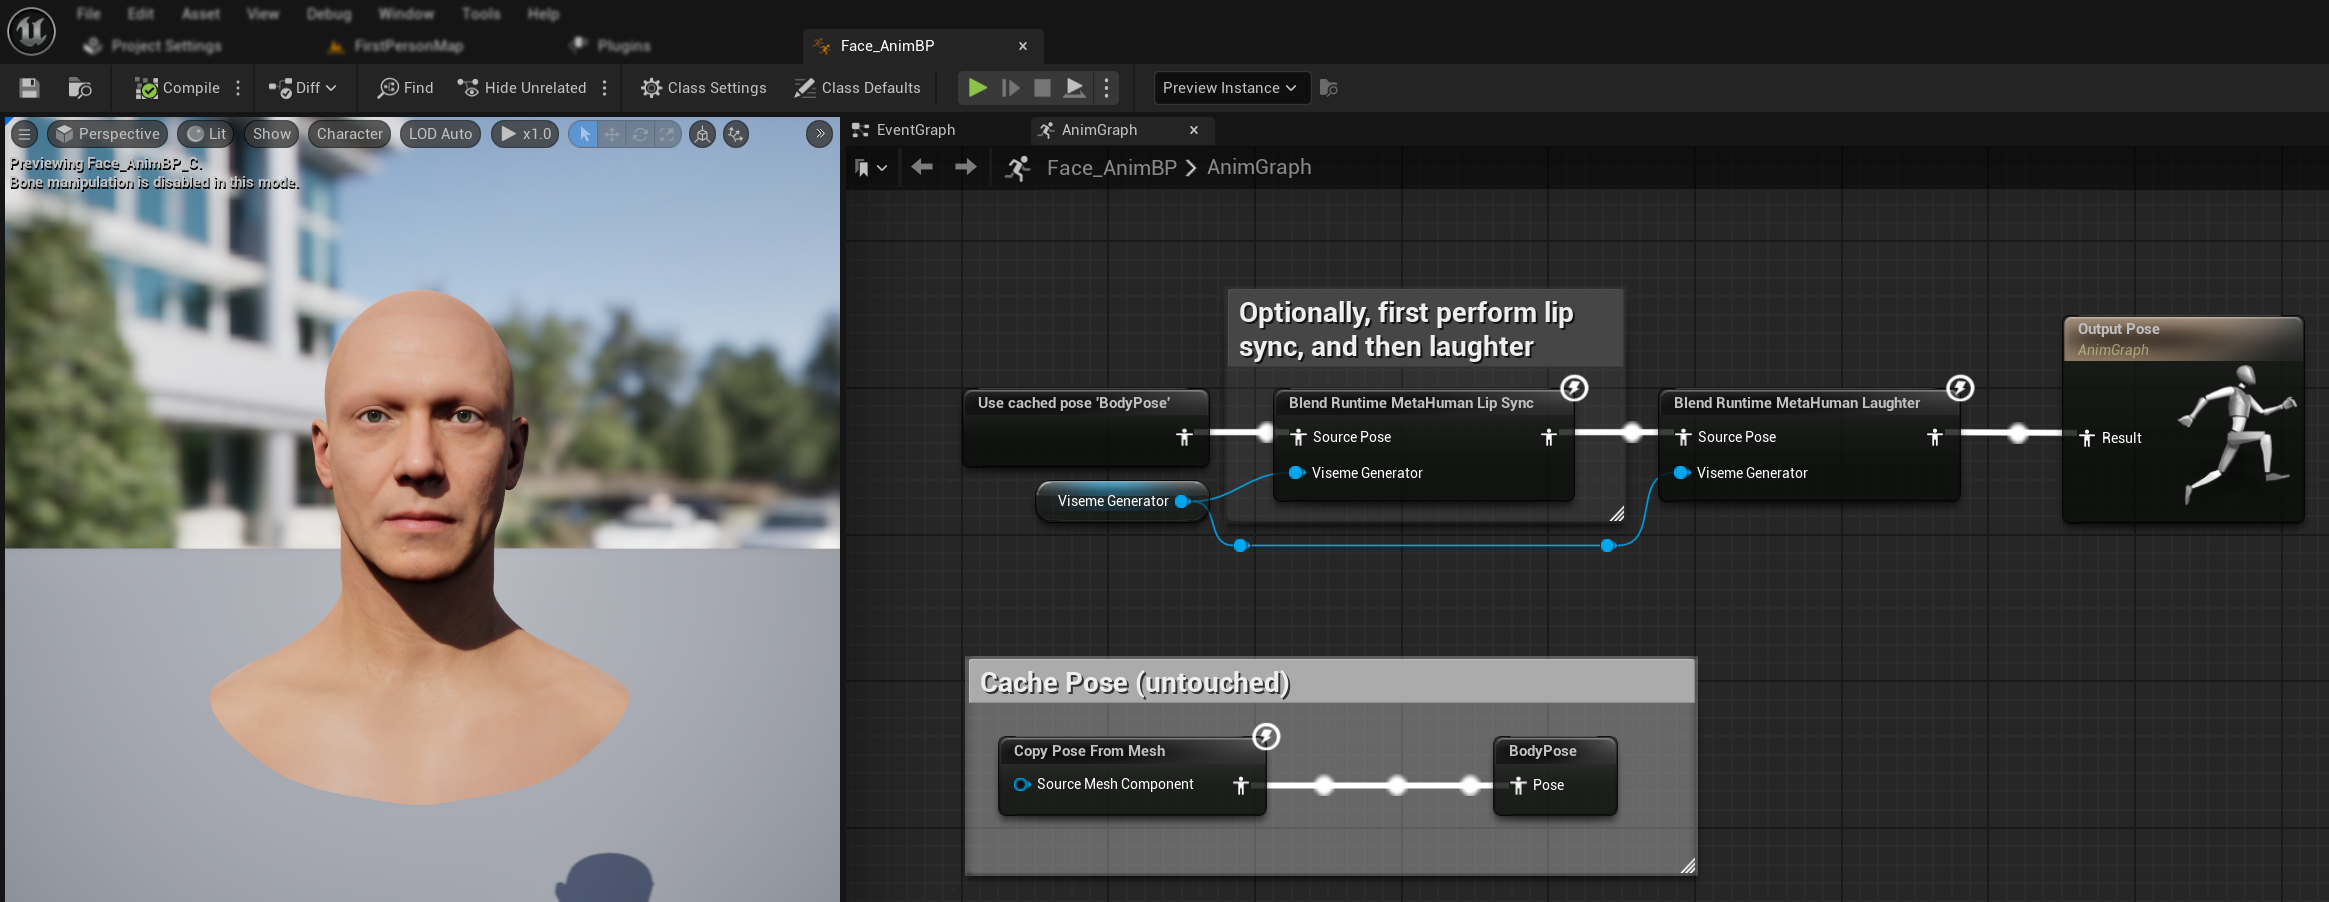
Wenn im Audio Lachen erkannt wird, animiert sich dein Charakter dynamisch entsprechend:
Lachen-Konfiguration
Der Node Blend Runtime MetaHuman Laughter hat seine eigenen Konfigurationsoptionen:
| Eigenschaft | Standard | Beschreibung |
|---|---|---|
| Interpolationsgeschwindigkeit | 25 | Steuert, wie schnell die Lippenbewegungen zwischen den Lachanimationen wechseln. Höhere Werte führen zu schnelleren, abrupteren Übergängen. |
| Zurücksetzzeit | 0.2 | Die Dauer in Sekunden, nach der das Lachen zurückgesetzt wird. Dies ist nützlich, um zu verhindern, dass das Lachen nach dem Ende des Audios weiterläuft. |
| Maximales Lachgewicht | 0.7 | Skaliert die maximale Intensität der Lachanimation (0.0 - 1.0). |
Hinweis: Die Lacherkennung ist derzeit nur mit dem Standard Model verfügbar.
Der Node Blend Realistic MetaHuman Lip Sync verfügt über Konfigurationsoptionen in seinem Eigenschaftenbereich:
| Eigenschaft | Standard | Beschreibung |
|---|---|---|
| Interpolationsgeschwindigkeit | 30 | Steuert, wie schnell Gesichtsausdrücke während aktiver Sprache übergehen. Höhere Werte führen zu schnelleren, abrupteren Übergängen. |
| Interpolationsgeschwindigkeit im Ruhezustand | 15 | Steuert, wie schnell Gesichtsausdrücke in den Ruhe-/Neutralzustand zurückkehren. Niedrigere Werte erzeugen sanftere, allmählichere Rückkehr zur Ruhepose. |
| Zurücksetzzeit | 0.2 | Dauer in Sekunden, nach der Lip Sync in den Ruhezustand zurückgesetzt wird. Nützlich, um zu verhindern, dass Ausdrücke nach dem Ende der Audiowiedergabe fortbestehen. |
| Ruhezustand beibehalten | false | Wenn aktiviert, wird der letzte emotionale Zustand während Ruhephasen beibehalten, anstatt auf neutral zurückzusetzen. |
| Augenausdrücke beibehalten | true | Steuert, ob augenbezogene Gesichtssteuerungen während des Ruhezustands beibehalten werden. Nur wirksam, wenn Ruhezustand beibehalten aktiviert ist. |
| Brauenausdrücke beibehalten | true | Steuert, ob augenbrauenbezogene Gesichtssteuerungen während des Ruhezustands beibehalten werden. Nur wirksam, wenn Ruhezustand beibehalten aktiviert ist. |
| Mundform beibehalten | false | Steuert, ob Mundform-Steuerungen (mit Ausnahme sprachspezifischer Bewegungen wie Zunge und Kiefer) während des Ruhezustands beibehalten werden. Nur wirksam, wenn Ruhezustand beibehalten aktiviert ist. |
Zustandserhaltung im Leerlauf
Die Funktion Preserve Idle State befasst sich damit, wie das Realistic-Modell Stillephasen handhabt. Anders als das Standard-Modell, das diskrete Viseme verwendet und während der Stille konsequent auf Nullwerte zurückkehrt, kann das neuronale Netz des Realistic-Modells eine subtile Gesichtspositionierung beibehalten, die von der Standard-Ruhepose des MetaHuman abweicht.
Wann aktivieren:
- Beibehaltung emotionaler Ausdrücke zwischen Sprachsegmenten
- Bewahrung der Persönlichkeitsmerkmale von Charakteren
- Sicherstellung der visuellen Kontinuität in filmischen Sequenzen
Regionale Steuerungsoptionen:
- Augenausdrücke: Bewahrt zusammengekniffene, geweitete Augen und die Positionierung der Augenlider
- Brauenausdrücke: Behält die Positionierung von Augenbrauen und Stirn bei
- Mundform: Behält die allgemeine Mundkrümmung bei, während Sprachbewegungen (Zunge, Kiefer) zurückgesetzt werden können
Kombination mit vorhandenen Animationen
Du siehst lieber Videos als zu lesen? Schau dir das Video-Tutorial an, das genau diese Einrichtung behandelt.
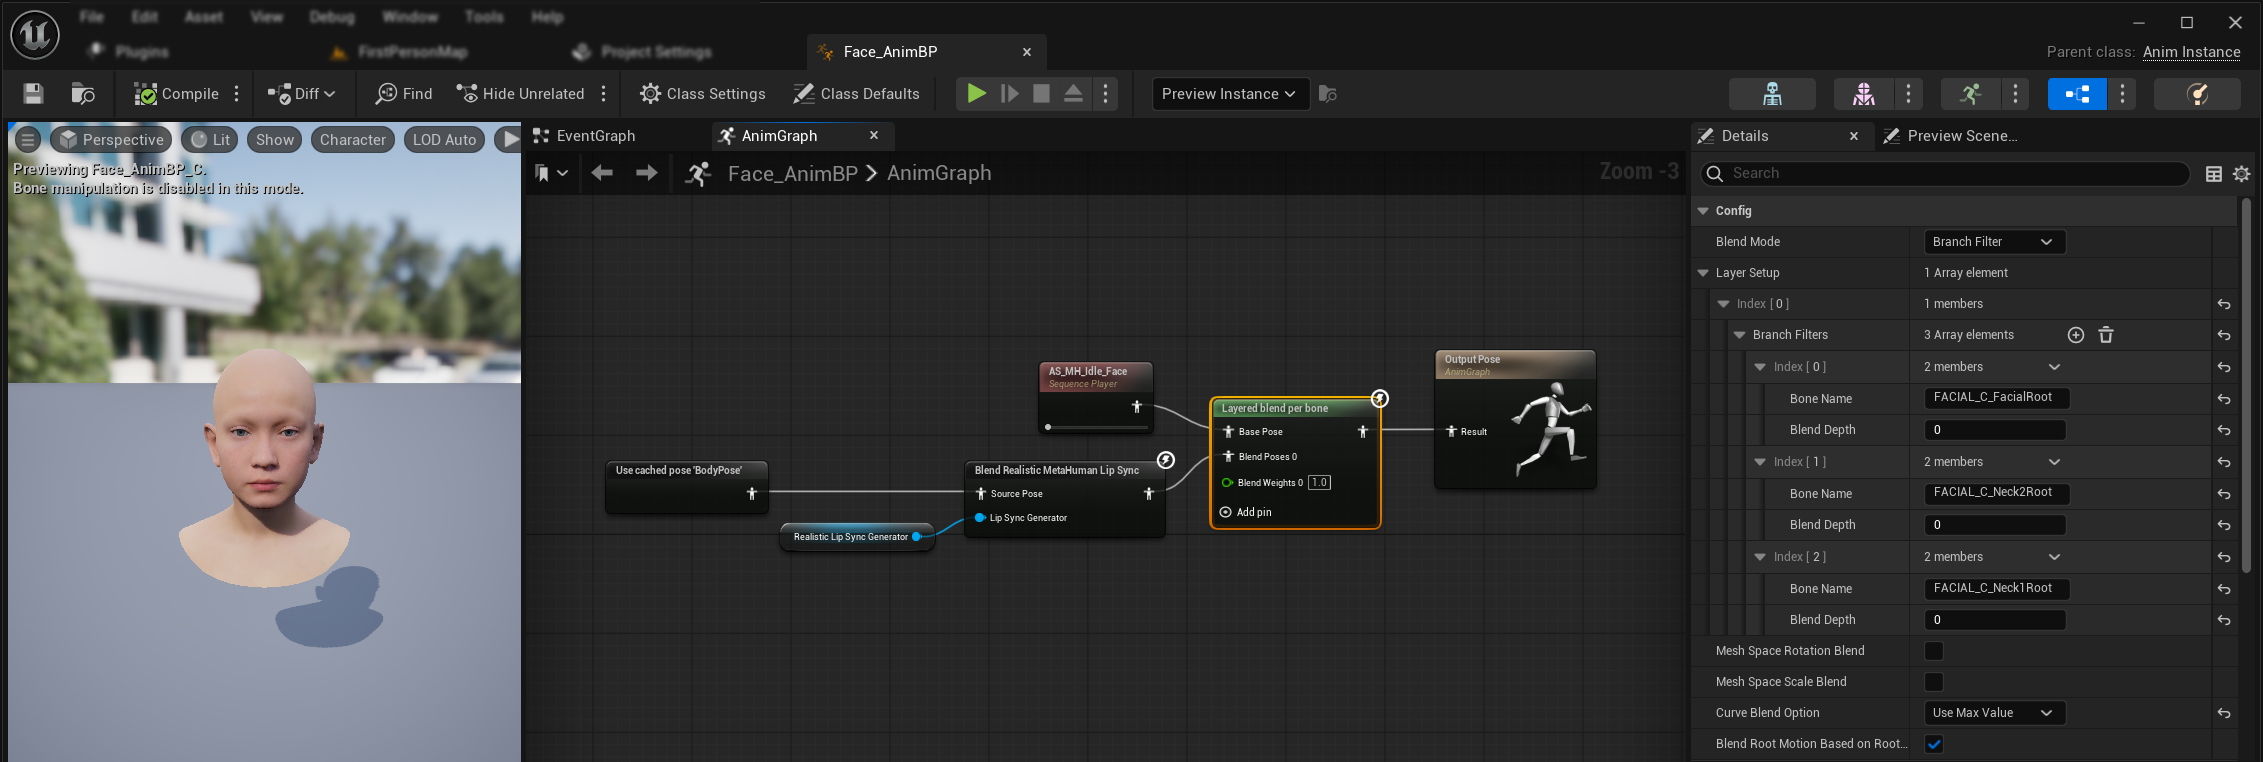
Um Lip Sync und Lachen zusammen mit bestehenden Körperanimationen und benutzerdefinierten Gesichtsanimationen anzuwenden, ohne diese zu überschreiben:
Dieses Setup gilt für das Face Animation Blueprint, da Lip Sync nicht Teil des Body Animation Blueprint ist. Für benutzerdefinierte Körperanimationen (z. B. Torso, Arme und andere Körperbewegungen) verbinden Sie einfach Ihre Animationssequenz (über einen Sequence Player) direkt mit der Output Pose im Body Animation Blueprint. Dort ist kein zusätzliches Setup erforderlich.
- Füge einen
Layered blend per bone-Node zwischen deinen Körperanimationen und der finalen Ausgabe hinzu. - Konfiguriere das Layer-Setup:
- Füge 1 Element zum
Layer Setup-Array hinzu - Füge 3 Elemente zu den
Branch Filtersfür den Layer hinzu, mit den folgendenBone Names:FACIAL_C_FacialRootFACIAL_C_Neck2RootFACIAL_C_Neck1Root
- Füge 1 Element zum
- Wichtig für benutzerdefinierte Gesichtsanimationen: Wähle in der
Curve Blend Option„Use Max Value“ aus. Dadurch können benutzerdefinierte Gesichtsanimationen (Ausdrücke, Emotionen usw.) ordnungsgemäß über die Lip Sync gelegt werden. - Stelle die Verbindungen her:
- Deine benutzerdefinierte Animation (typischerweise ein
Sequence Playermit dem gewünschten Animationssequenz-Asset) →Base Pose-Eingang - Gesichtsanimations-Ausgabe (von Lip-Sync- und/oder Lach-Knoten) →
Blend Poses 0-Eingang - Geschichteter Blend-Knoten → finale
Result-Pose
- Deine benutzerdefinierte Animation (typischerweise ein
Morph Target-Set-Auswahl
- Standardmodell
- Realistische Modelle
Das Standardmodell verwendet Pose Assets, die von Natur aus jede beliebige Namenskonvention für Morph Targets durch die Einrichtung eines benutzerdefinierten Pose Assets unterstützen. Es ist keine zusätzliche Konfiguration erforderlich.
Der Blend Realistic MetaHuman Lip Sync-Node enthält eine Morph Target Set-Eigenschaft, die bestimmt, welche Namenskonvention für Morph Targets bei der Gesichtsanimation verwendet werden soll:
| Morph Target Set | Beschreibung | Anwendungsfälle |
|---|---|---|
| MetaHuman (Standard) | Standard-MetaHuman-Morph-Target-Namen (z. B. CTRL_expressions_jawOpen) | MetaHuman-Charaktere |
| ARKit | Apple ARKit-kompatible Namen (z. B. JawOpen, MouthSmileLeft) | ARKit-basierte Charaktere |
Konvertieren von Charakteren in ARKit- oder MetaHuman-Blendshapes
Wenn dein Charakter nicht nativ die ARKit-Standard-Blendshape-Namen verwendet, können mehrere beliebte kommerzielle Charaktersysteme konvertiert werden, um sie zu erzeugen (oder, für CC5, direkt in native MetaHuman-Blendshapes konvertiert werden). Dadurch erhältst du Zugriff auf das obige ARKit- oder MetaHuman-Morph-Target-Set, anstelle des manuellen Viseme-Mapping-Prozesses, der für das Standardmodell erforderlich ist. CC4- und CC5-Charaktere werden hier unterschiedlich behandelt, da CC5-Charaktere das native Gesichts-Rig von MetaHuman gemeinsam nutzen können, anstatt überhaupt eine ARKit-Konvertierung zu benötigen. CC5: In MetaHuman-Blendshapes umwandeln (empfohlen) Wenn dein Charakter in CC5 mit dem HD-Gesichtsprofil erstellt wurde, teilt er bereits die Gesichtssteuerungen und das Skelett von MetaHuman, sodass ARKit-Blendshapes nicht manuell generiert werden müssen. Stattdessen: Nach dem Import wähle die Option MetaHuman Morph Target Set anstelle von ARKit, da die Blendshapes des Charakters bereits die native MetaHuman-Benennung verwenden. CC4 (oder CC5 ohne das HD-Profil): in ARKit-Blendshapes umwandeln Wenn du CC4 verwendest oder einen CC5-Charakter, der nicht das HD-Gesichtsprofil nutzt, verwende stattdessen die manuelle ARKit-Konvertierung. Stelle vor dem Start sicher, dass das Facial Profile deines Charakters auf CC4 Extended eingestellt ist (nicht Standard, Extended-Plus oder das neuere HD Facial Profile). Das Blendshape-Mapping des Skripts ist fest auf die Slider-Namen von Extended ausgelegt; andere Profile verwenden abweichende Namenskonventionen, und das Skript überspringt die erwarteten Slider stillschweigend oder findet sie nicht. Lade dieses Skript herunter: Öffne das Skript in einem Texteditor und weise dort, wo Wähle in Character Creator deinen Charakter aus und wähle dann im oberen Menü unter Script die Option Load Python. Wähle anschließend das Skript aus, das du gerade bearbeitet hast. Das Skript erstellt nun den vollständigen Satz von ARKit-Blendshapes aus den Standard-Reallusion-Slidern und exportiert sie als OBJ-Dateien. Dies kann einige Minuten dauern. Du kannst diese Formen jetzt importieren, indem du zum Fenster Facial Profile Editor gehst. Klicke auf die Schaltfläche Edit Expressions und wähle im Drop-down-Menü Batch Import die Option OBJ aus. Hier kannst du den Ordner importieren, auf den du zuvor verwiesen hast. Dieser listet dann alle ARKit-Formen auf. Schreibe einen Namen in die Zielkategorie, z. B. AR_Kit, und klicke auf OK. Dadurch wird eine neue Kategorie unter Expression erstellt. Du kannst alle anderen Kategorien deaktivieren. Sobald die ARKit-Kategorie eingerichtet ist, exportiere deinen Charakter wie gewohnt als FBX. Dadurch erhält der Charakter die standardmäßigen 52 ARKit-Blendshapes, die du dann mit der Option ARKit Morph Target Set oben verwenden kannst. Hinweis: Die Kieferbewegung wird im Rig von CC4 teilweise durch Knochenrotation statt durch reine Blendshapes angetrieben, daher kann Die FACS-Morphs von Daz, die nativ auf Genesis 8.1 und Genesis 9 verfügbar sind, sind bereits ARKit-kompatibel, ohne dass eine Umbenennung erforderlich ist. Das einfache Genesis 8 (nicht 8.1) enthält diese standardmäßig nicht. Du musst entweder stattdessen Genesis 8.1 verwenden oder ein separates FACS-Morph-Paket hinzufügen. Das aktiv gepflegte Diffeomorphic-Add-on (eine Brücke zwischen Daz Studio und Blender, nicht mit Daz 3D verbunden) ist der empfohlene Weg, diese in Unreal zu bringen: Nach dem Export verwenden Sie die Option ARKit Morph Target Set oben. Hinweis: Die Formen für die Blickrichtung auf den Wimpern und Augäpfeln werden möglicherweise nicht vollständig übernommen, da sie anders als das Haupt-Gesichtsmesh gesteuert werden, aber dies beeinträchtigt nicht die Lippensynchronisation, die nur Mund- und Kieferformen benötigt.Reallusion CC4/CC5 und Daz Genesis 8.1/9 Konvertierungsanleitungen (zum Erweitern klicken)
rl_export_arkit_objs.pyoutput_dir = "path/to/your/target/folder" steht, den Pfad zu deinem Exportordner zu. Achte darauf, Vorwärtsschrägstriche / zu verwenden.


jawOpen nach dem Export schwach wirken oder den Mund nicht überzeugend öffnen. Wenn dies passiert, aktiviere Mouth Open as Morph in den FBX-Exportoptionen; dies backt die knochengesteuerte Bewegung des Kiefers in ein dediziertes Blendshape, das anstelle des Standard-Blendshapes als Quelle für jawOpen zugewiesen werden kann. Alternativ kann das Add-on cc_blender_tools den Charakter über Blender leiten, um dies und andere Shape-Probleme zu beheben; siehe den Abschnitt „Blender Round Trip“ in seiner Dokumentation für den Workflow (der Seitentitel erwähnt Unity, aber dieser spezifische Abschnitt ist engine-unabhängig).
Feinabstimmung des Lip-Sync-Verhaltens
Skalierung spezifischer Lip-Sync-Kurven
Du kannst einzelne Gesichtsbewegungen, die durch Lip Sync erzeugt werden, mit einem Modify Curve-Node abschwächen (oder verstärken). Das ist nützlich, wenn eine bestimmte Kurve für deinen Audioinhalt oder Charakter zu ausgeprägt wirkt.
Einrichtung:
- Füge nach deinem Lip-Sync-Blend-Node einen
Modify Curve-Node hinzu - Klicke mit der rechten Maustaste auf den Node und wähle Add Curve Pin aus, dann gib den Namen der Kurve ein, die du skalieren möchtest
- Setze die Eigenschaft Apply Mode des Nodes auf Scale
- Lege den Parameter Value fest: Werte unter 1,0 dämpfen die Bewegung, Werte über 1,0 verstärken sie (z. B. 0,8 = 20 % Reduktion)
Häufig skalierte Kurven:
| Kurvenname | Zweck | Gilt für | Typische Anpassung |
|---|---|---|---|
CTRL_expressions_tongueOut | Vorwärtsbewegung der Zunge bei bestimmten Phonemen | Standardmodell | 0.8, um die Vorwölbung zu verringern |
CTRL_expressions_jawOpen | Öffnungsbereich des Kiefers | Realistische Modelle | 0.9, um die Kieferbewegung zu verringern |
Du kannst mehrere Kurven-Pins zum selben Modify Curve-Node hinzufügen, um mehrere Kurven gleichzeitig zu skalieren.
Stimmungsspezifische Feinabstimmung
Für Modelle mit Stimmungsunterstützung können Sie bestimmte emotionale Ausdrücke feinabstimmen:
Augenbrauen-Steuerung:
CTRL_expressions_browRaiseInL/CTRL_expressions_browRaiseInR- Inneres Anheben der AugenbraueCTRL_expressions_browRaiseOuterL/CTRL_expressions_browRaiseOuterR- Äußeres Anheben der AugenbraueCTRL_expressions_browDownL/CTRL_expressions_browDownR- Senken der Augenbraue
Augenausdruckssteuerung:
CTRL_expressions_eyeSquintInnerL/CTRL_expressions_eyeSquintInnerR– Zusammenkneifen der AugenCTRL_expressions_eyeCheekRaiseL/CTRL_expressions_eyeCheekRaiseR– Anheben der Wangen
Modellvergleich und -auswahl
Auswahl zwischen Modellen
Bei der Entscheidung, welches Lip-Sync-Modell Sie für Ihr Projekt verwenden sollten, berücksichtigen Sie diese Faktoren:
| Berücksichtigung | Standardmodell | Realistisches Modell | Stimmungsfähiges realistisches Modell |
|---|---|---|---|
| Zeichenkompatibilität | MetaHumans und alle benutzerdefinierten Zeichentypen | MetaHumans (und ARKit)-Zeichen | MetaHumans (und ARKit)-Zeichen |
| Visuelle Qualität | Gute Lip Sync mit effizienter Leistung | Verbesserter Realismus mit natürlicheren Mundbewegungen | Verbesserter Realismus mit emotionalen Ausdrücken |
| Leistung | Optimiert für alle Plattformen einschließlich Mobil/VR | Höherer Ressourcenbedarf | Höherer Ressourcenbedarf |
| Funktionen | 14 Viseme, Lacherkennung | 81 Gesichtssteuerungen, 3 Optimierungsstufen | 81 Gesichtssteuerungen, 12 Stimmungen, konfigurierbare Ausgabe |
| Plattformunterstützung | Windows, Android, Quest | Windows, Mac, iOS, Linux, Android, Quest | Windows, Mac, iOS, Linux, Android, Quest |
| Anwendungsfälle | Allgemeine Anwendungen, Spiele, VR/AR, Mobil | Filmische Erlebnisse, Nahaufnahme-Interaktionen | Emotionales Geschichtenerzählen, fortgeschrittene Zeicheninteraktion |
Engine-Versionskompatibilität
Wenn du Unreal Engine 5.2 verwendest, funktionieren die Realistic Models möglicherweise aufgrund eines Fehlers in der Resampling-Bibliothek von UE nicht korrekt. Für UE 5.2-Nutzer, die eine zuverlässige Lip-Sync-Funktionalität benötigen, verwende bitte stattdessen das Standard Model.
Dieses Problem ist spezifisch für UE 5.2 und betrifft andere Engine-Versionen nicht.
Leistungsempfehlungen
- Für die meisten Projekte bietet das Standardmodell eine hervorragende Balance zwischen Qualität und Leistung
- Verwende das realistische Modell, wenn du die höchste visuelle Wiedergabetreue für MetaHuman-Charaktere benötigst
- Verwende das stimmungsfähige realistische Modell, wenn die Steuerung des emotionalen Ausdrucks für deine Anwendung wichtig ist
- Berücksichtige die Leistungsfähigkeit deiner Zielplattform, wenn du zwischen den Modellen wählst
- Teste verschiedene Optimierungsstufen, um die beste Balance für deinen spezifischen Anwendungsfall zu finden
Fehlerbehebung
Häufige Probleme
Generator-Neuerstellung für realistische Modelle: Für einen zuverlässigen und konsistenten Betrieb mit den realistischen Modellen wird empfohlen, den Generator jedes Mal neu zu erstellen, wenn Sie nach einer Phase der Inaktivität neue Audiodaten einspeisen möchten. Dies ist auf das Verhalten der ONNX-Laufzeit zurückzuführen, das dazu führen kann, dass die Lippensynchronisation nicht mehr funktioniert, wenn Generatoren nach Phasen der Stille wiederverwendet werden.
Zum Beispiel könntest du den Lip-Sync-Generator bei jedem Wiedergabestart neu erstellen, etwa immer wenn du Play Sound 2D aufrufst oder eine andere Methode verwendest, um die Wiedergabe der Schallwelle und den Lip-Sync zu starten:
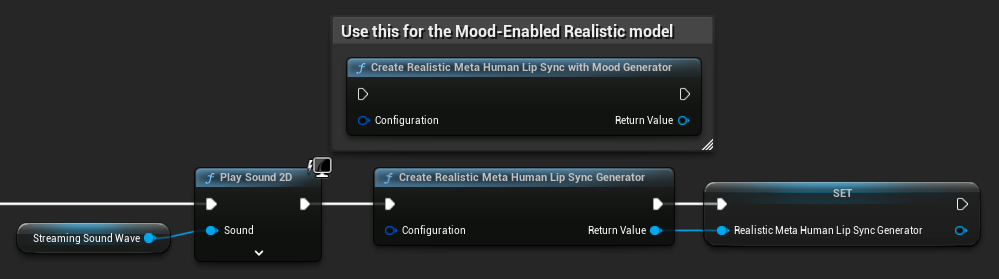
Plugin-Speicherort für die Runtime Text To Speech-Integration: Wenn Sie Runtime MetaHuman Lip Sync zusammen mit Runtime Text To Speech verwenden (beide Plugins nutzen ONNX Runtime), können Probleme auftreten, wenn die Plugins im Marketplace-Ordner der Engine installiert sind. So beheben Sie das:
- Finde beide Plugins in deinem UE-Installationsordner unter
\Engine\Plugins\Marketplace(z. B.C:\Program Files\Epic Games\UE_5.6\Engine\Plugins\Marketplace) - Verschiebe sowohl den Ordner
RuntimeMetaHumanLipSyncals auch den OrdnerRuntimeTextToSpeechin den OrdnerPluginsdeines Projekts - Wenn dein Projekt keinen Ordner
Pluginshat, erstelle einen im selben Verzeichnis wie deine.uproject-Datei - Starte den Unreal Editor neu
Dies behebt Kompatibilitätsprobleme, die auftreten können, wenn mehrere auf ONNX Runtime basierende Plugins aus dem Marketplace-Verzeichnis der Engine geladen werden.
Packaging-Konfiguration (Windows): Wenn Lip Sync in Ihrem gepackten Projekt unter Windows nicht korrekt funktioniert, stellen Sie sicher, dass Sie die Shipping-Build-Konfiguration anstelle von Development verwenden. Die Development-Konfiguration kann Probleme mit der ONNX-Runtime für realistische Modelle in gepackten Builds verursachen.
Um dies zu beheben:
- In deinen Projekteinstellungen → Packaging, setze die Build-Konfiguration auf Shipping
- Verpacke dein Projekt neu
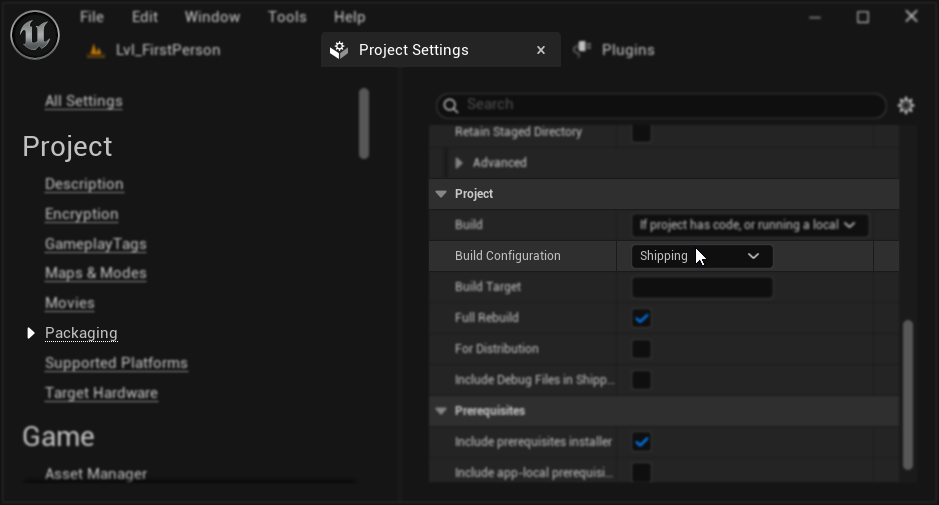
In manchen Blueprint-only-Projekten baut Unreal Engine möglicherweise trotzdem in der Development-Konfiguration, selbst wenn Shipping ausgewählt ist. Wenn dies passiert, konvertiere dein Projekt in ein C++-Projekt, indem du mindestens eine C++-Klasse hinzufügst (sie kann leer sein). Gehe dazu im UE-Editor-Menü zu Tools → New C++ Class und erstelle eine leere Klasse. Dadurch wird das Projekt gezwungen, korrekt in der Shipping-Konfiguration zu bauen. Dein Projekt kann funktional Blueprint-only bleiben, die C++-Klasse wird nur für die korrekte Build-Konfiguration benötigt.
Beeinträchtigte Lip-Sync-Reaktionsfähigkeit: Wenn Sie feststellen, dass die Lip-Sync-Reaktionsfähigkeit bei Verwendung von Streaming Sound Wave oder Capturable Sound Wave mit der Zeit nachlässt, kann dies durch Speicheransammlung verursacht werden. Standardmäßig wird der Speicher jedes Mal neu zugewiesen, wenn neues Audio angehängt wird. Um dieses Problem zu vermeiden, rufen Sie die Funktion ReleaseMemory regelmäßig auf, um angesammelten Speicher freizugeben, etwa alle 30 Sekunden.
Leistungsoptimierung:
- Passen Sie die Verarbeitungs-Chunk-Größe für Realistic-Modelle an Ihre Leistungsanforderungen an
- Verwenden Sie geeignete Thread-Anzahlen für Ihre Zielhardware
- Erwägen Sie die Verwendung des Ausgabetyps „Nur Mund“ für mood-fähige Modelle, wenn keine vollständige Gesichtsanimation benötigt wird