デモプロジェクト
Runtime MetaHuman Lip Sync をすぐに使い始められるよう、すぐに使えるデモプロジェクトが2つ用意されています。どちらもUnreal Engine 5.6+ で構築され、Blueprintのみで、Windows、Mac、Linux、iOS、Android、およびAndroidベースのプラットフォーム(Meta Quest を含む)でクロスプラットフォーム動作します。
利用可能なデモプロジェクト
- AI対話NPC / インタラクティブアバター
- 基本的なリップシンクデモ
完全なAI会話型アバターワークフロー。音声認識、AIチャットボット(LLM)、テキスト読み上げ、オーディオ再生とリアルタイムのリップシンクを組み合わせ、すべて単一のプロジェクト内で連携して動作します。ゲーム、インタラクティブキオスク、バーチャルプロダクション、ミュージアム展示、デジタルアシスタント、トレーニングシミュレーションなど、幅広いユースケースに適しています。
パイプライン概要
🎤 Microphone → Speech Recognition → 💬 LLM Chatbot → 🔊 Text-to-Speech → 👄 Lip Sync + Playback
LLMがストリーミングモードに設定されている場合、その出力は文ごとに分割され、各文が完了するたびにTTSへ送信されます。完全な応答を待つのではなく、これによりレイテンシーを最小限に抑えます。
TTSとリップシンクは同じ原理に従います。ストリーミングモードを有効にすると、オーディオは完全なクリップを待つのではなく、到着したチャンク単位で処理され、アニメーション化されます。
動画
クイックプレビュー(約30秒)
デモの動作を簡単に紹介するショーケースです。
完全なウォークスルー
セットアップ、設定、そして完全な会話パイプラインを網羅した詳細なウォークスルーです。
ダウンロード
必須プラグインとオプションプラグイン
デモプロジェクトはモジュール式です。使用したいプロバイダーのプラグインだけが必要です。
| プラグイン | 目的 | 必須? |
|---|---|---|
| Runtime MetaHuman Lip Sync | リップシンクアニメーション | ✅ 常に |
| Runtime Audio Importer | オーディオのキャプチャと処理 | ✅ 常に |
| Runtime Speech Recognizer | オフライン音声認識(whisper.cpp) | ✅ 常に |
| Runtime AI Chatbot Integrator | 外部LLM(OpenAI、Claude、DeepSeek、Gemini、Grok、Ollama)および/または外部TTS(OpenAI、ElevenLabs) | 🔶 オプション |
| Runtime Local LLM | llama.cppによるローカルLLM推論(Llama、Mistral、Gemmaなど、GGUFモデル) | 🔶 オプション |
| Runtime Text To Speech | PiperとKokoroによるローカルTTS | 🔶 オプション |
上記の各プラグインは個別にオプションですが、デモを動作させるには少なくとも1つのLLMプロバイダーと少なくとも1つのTTSプロバイダーが必要です。自由に組み合わせてください(例:ローカルLLM + ElevenLabs TTS、またはOpenAI LLM + ローカルTTS)。
モジュラーアーキテクチャ
Content フォルダ内に Modules フォルダがあり、その中に3つのサブフォルダが含まれています。
Content/
└── Modules/
    ├── RuntimeAIChatbotIntegrator/   ← External LLMs and/or external TTS
    ├── RuntimeLocalLLM/              ← Local LLM via llama.cpp
    └── RuntimeTextToSpeech/          ← Local TTS via Piper/Kokoro
オプショナルプラグインのいずれか(または複数)を取得していない場合は、対応するフォルダを単純に削除してください。デモプロジェクトの基本アセット(ゲームインスタンス、ウィジェットなど)はこれらのモジュールを直接参照していないため、削除してもアセット参照エラーは発生しません。設定UIは、フォルダが存在しないプロバイダーを自動的に非表示にします。
このモジュール性は、LLM および TTS プロバイダーにのみ適用されます。音声認識(Runtime Speech Recognizer)とリップシンク(Runtime MetaHuman Lip Sync)は、基本デモプロジェクトの一部であり、常に必要です。
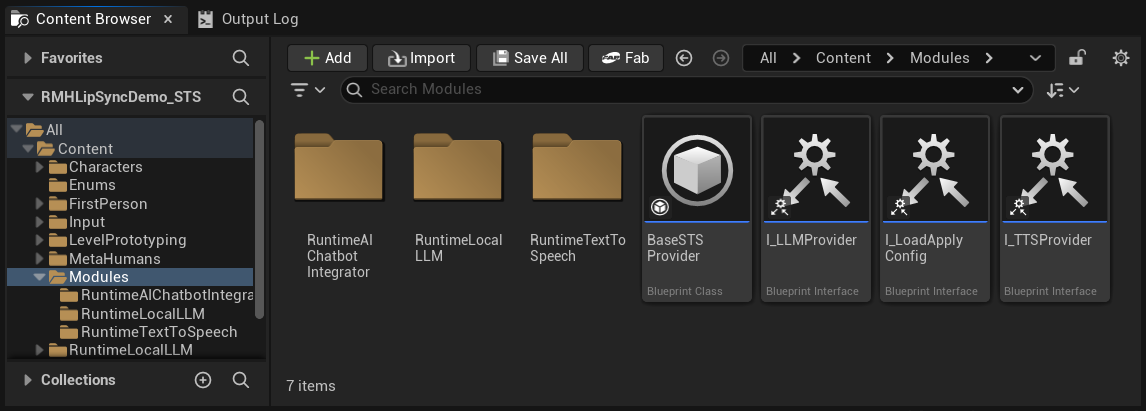
初回起動時、Unrealが不足しているオプションプラグインを無効化するか尋ねることがあります - はいをクリックしてください。対応するContent/Modules/フォルダも削除済みであることを確認してください(上記参照)。
バンドル拡張プラグイン
Silero VAD、WebRTC AEC3、および標準リップシンク拡張機能(クリックして展開)
デモのソース版には、Plugins/ フォルダ内に3つの無料拡張プラグインが同梱されています:RuntimeAudioImporterSileroVAD(ニューラルVAD)、RuntimeAudioImporterWebRTCAEC3(エコーキャンセリング)、および RuntimeMetaHumanLipSync_Standard(標準リップシンクモデル)です。
同梱のバイナリは UE 5.6 用に事前ビルドされています。UE 5.7 / 5.8 の場合は、ソースからビルドするか(各拡張機能のドキュメントを参照)、事前ビルド済みバイナリを使用してください:UE 5.7 · UE 5.8。インストール方法:Plugins/ 内の既存の3つのフォルダを削除し、アーカイブの内容を Plugins/ に展開して置き換えます。
3つともオプションです - 必要ない場合は、起動前に Plugins/ からフォルダを削除するだけです。
デモプロジェクトのレイアウト
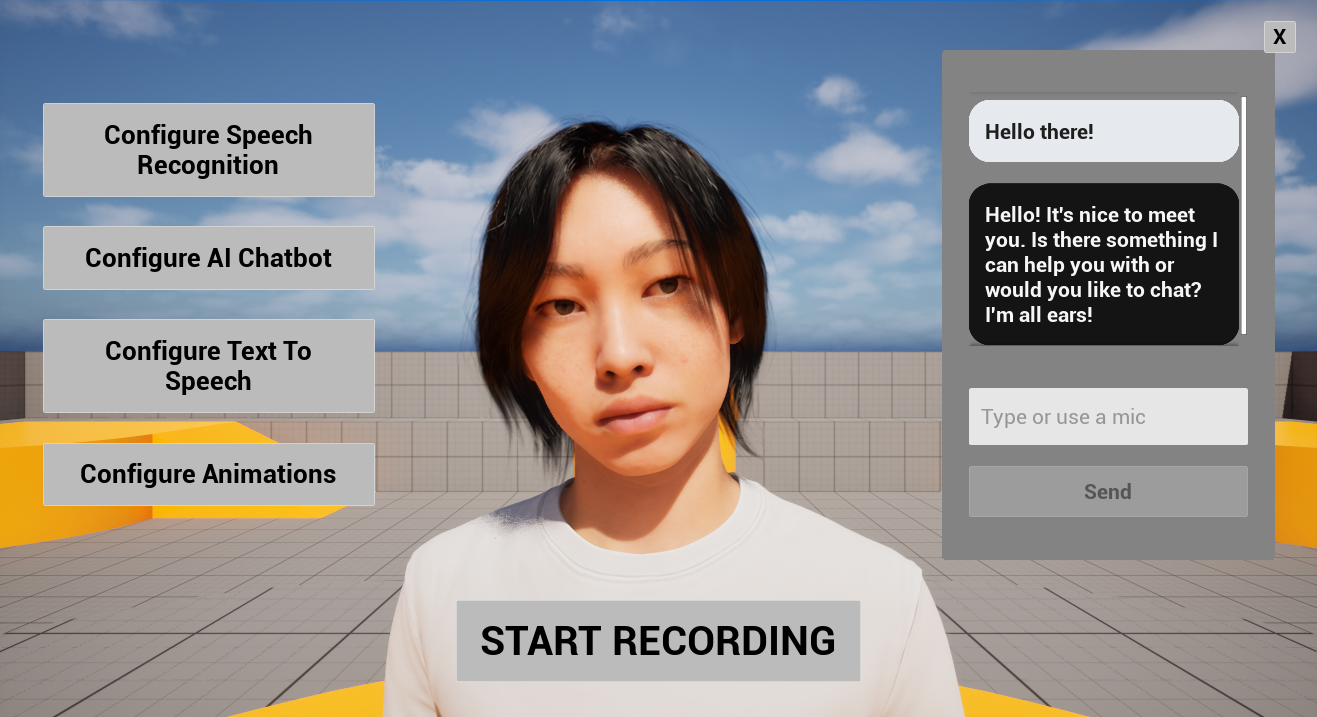
以下に示すユーザーインターフェースは、完全にUMG(Unreal Motion Graphics)で構築されており、パイプライン(音声認識 → LLM → TTS → リップシンク)をデモンストレーションすることのみを目的としています。プロジェクトのビジュアルデザイン、操作スキーム、またはプラットフォーム(VR/AR、モバイル、コンソール、キオスクなど)に合わせて、自由に再スタイル化または置き換えできます。ユースケースで特定のウィジェットが不要な場合は、単に非表示にすることもできます(例:その可視性をCollapsedまたはHiddenに設定)。
| Area | 画面には何があるか |
|---|---|
| 中央 | MetaHumanキャラクター。 |
| 左側 | 4つの設定ボタン(音声認識、AIチャットボット、テキスト読み上げ、アニメーション)。詳細は以下で説明します。 |
| 中央下部 | 録音開始ボタン。クリックすると音声会話が始まります。マイク音声がキャプチャされ、文字起こしされ、LLMに送信され、応答がTTSで合成され、リップシンク付きで再生されます。完全にハンズフリーです。 |
| 右中央 | 会話履歴ウィジェット。あなたとAIの間のやり取り全体(ユーザーとアシスタントの両方のメッセージ)が表示されます。また、テキスト入力フィールドも含まれており、音声認識を使わずに直接メッセージを入力できます。テスト用、アクセシビリティ用、またはマイクが利用できない場合に便利です。 |
同じセッション内で、両方の入力モードを自由に混在させることができます。メッセージによっては音声で話し、他のメッセージはタイピングで入力できます。
リップシンクがテストを続けるほどオーディオからどんどん遅れていく場合(固定の遅延だけでなく)、下のアニメーション設定の処理チャンクサイズを参照してください。
設定ボタン
左側の4つの設定ボタンは、パイプラインの各部分専用のパネルを開きます。
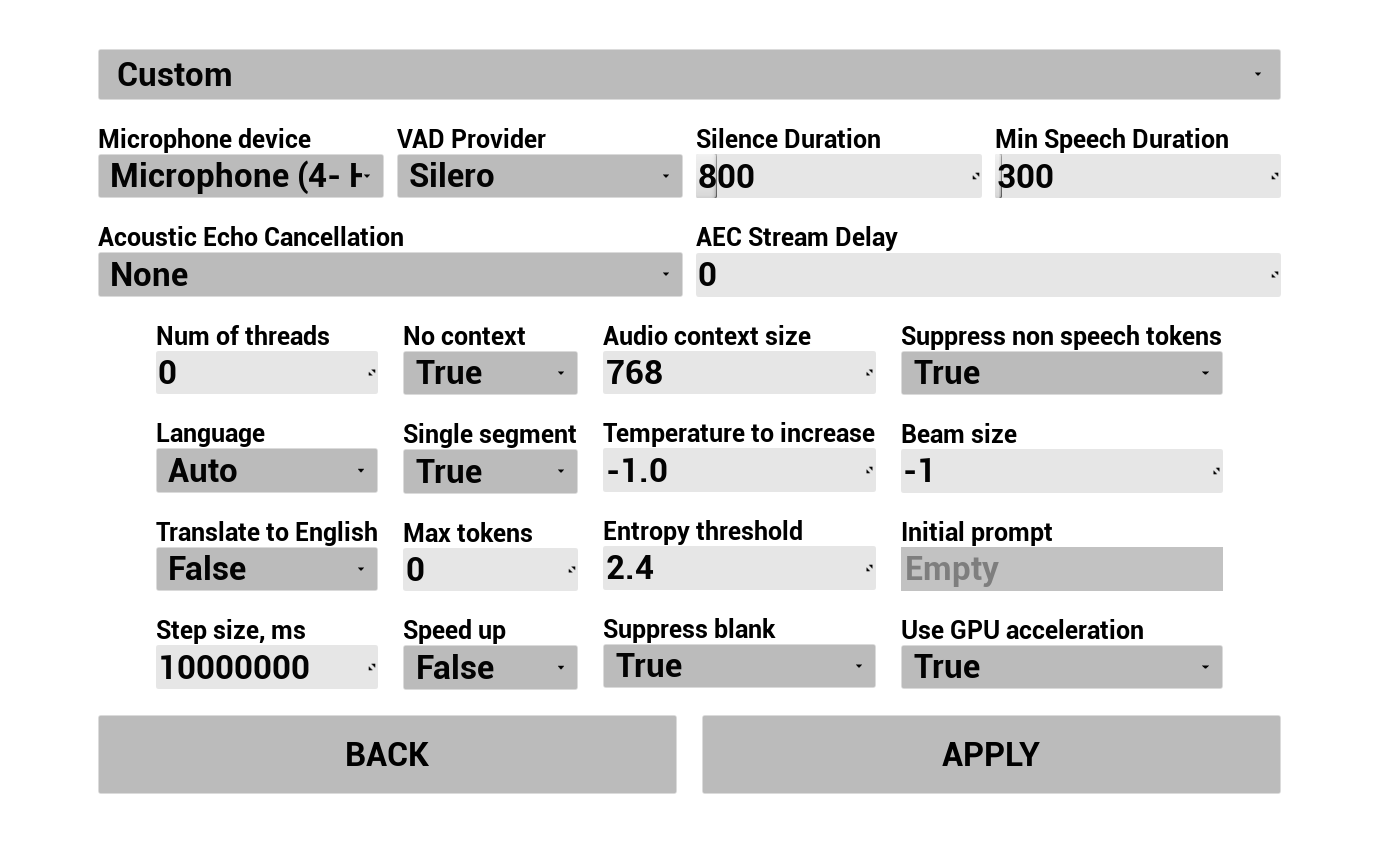
1. 音声認識を設定する
ユーザーの音声がどのようにキャプチャされ、文字起こしされるかを設定します:
- 言語を選択
- 音声認識パラメータを調整(Whisperモデル設定)
- AEC(音響エコーキャンセレーション)を設定
- VAD(音声アクティビティ検出)を設定
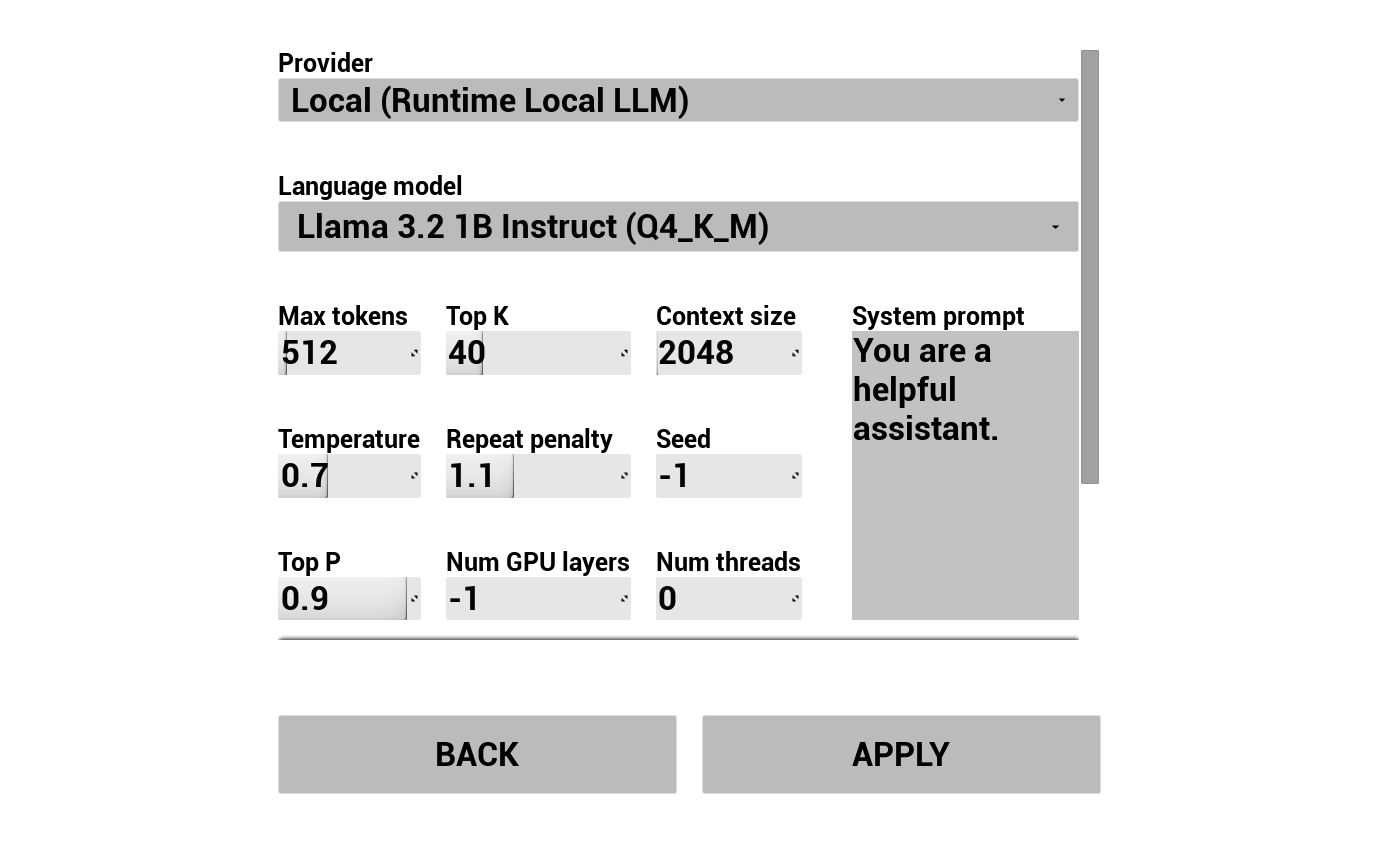
2. AIチャットボットを設定する
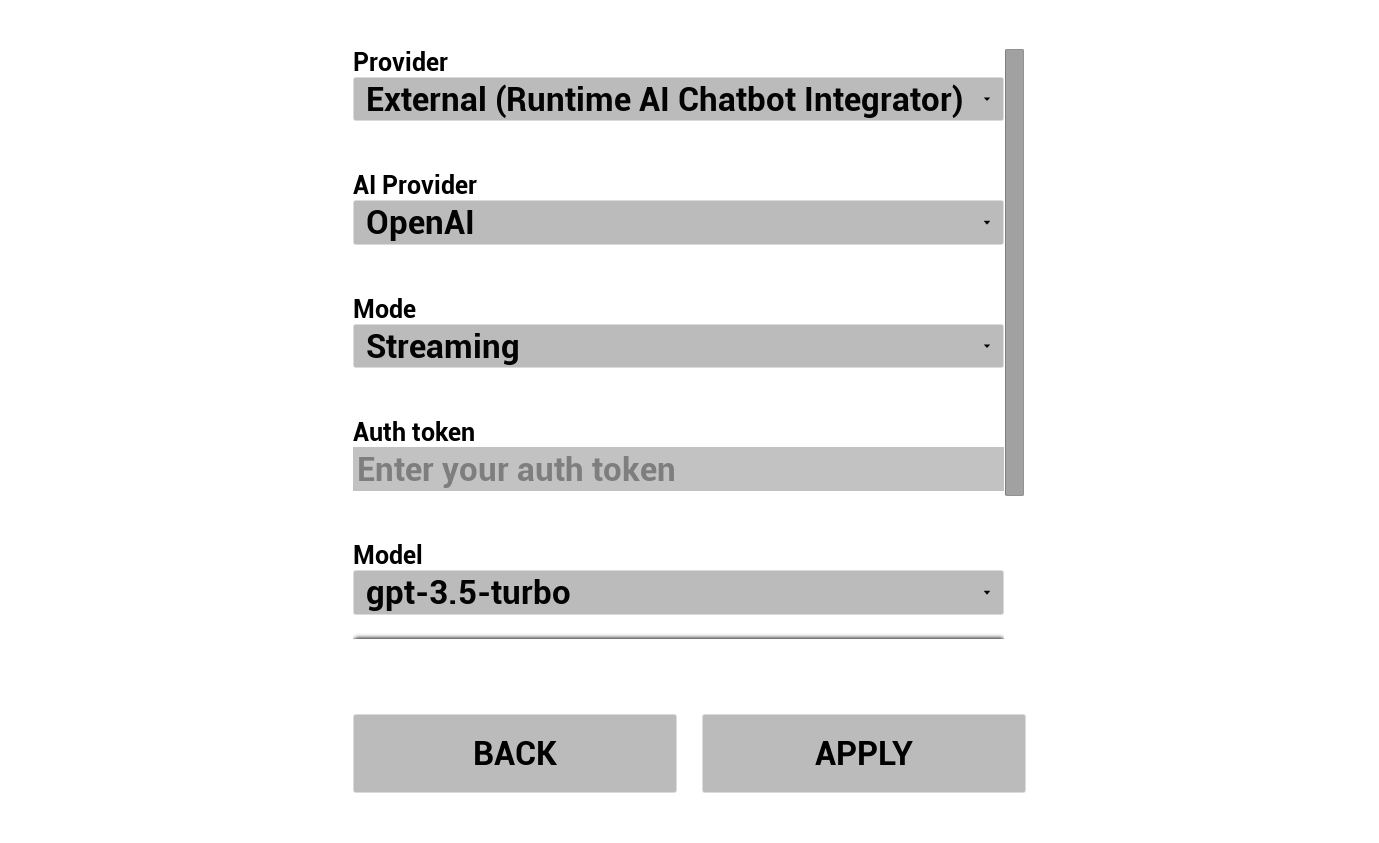
LLMプロバイダーを選択して設定してください:
- プロバイダーを選択します(Runtime AI Chatbot Integrator または Runtime Local LLM)
- モードを選択します:通常またはストリーミング(プロバイダーに依存します。ストリーミングは文単位のTTS引き渡しを有効にします。パイプライン概要を参照)
- 外部プロバイダーの場合:認証トークン、モデル名など
- ローカルLLMの場合:GGUFモデルを選択し、コンテキストサイズやその他の推論パラメータを設定します。また、デモから直接実行時に独自のGGUFモデルをダウンロード(例:URL経由)し、プロジェクトを再ビルドせずにすぐに使用することもできます。
プロバイダーのコンボボックスには、Content/Modules/ にプラグインモジュールフォルダーが存在するプロバイダーのみが表示されます。
3. Text To Speechを設定する
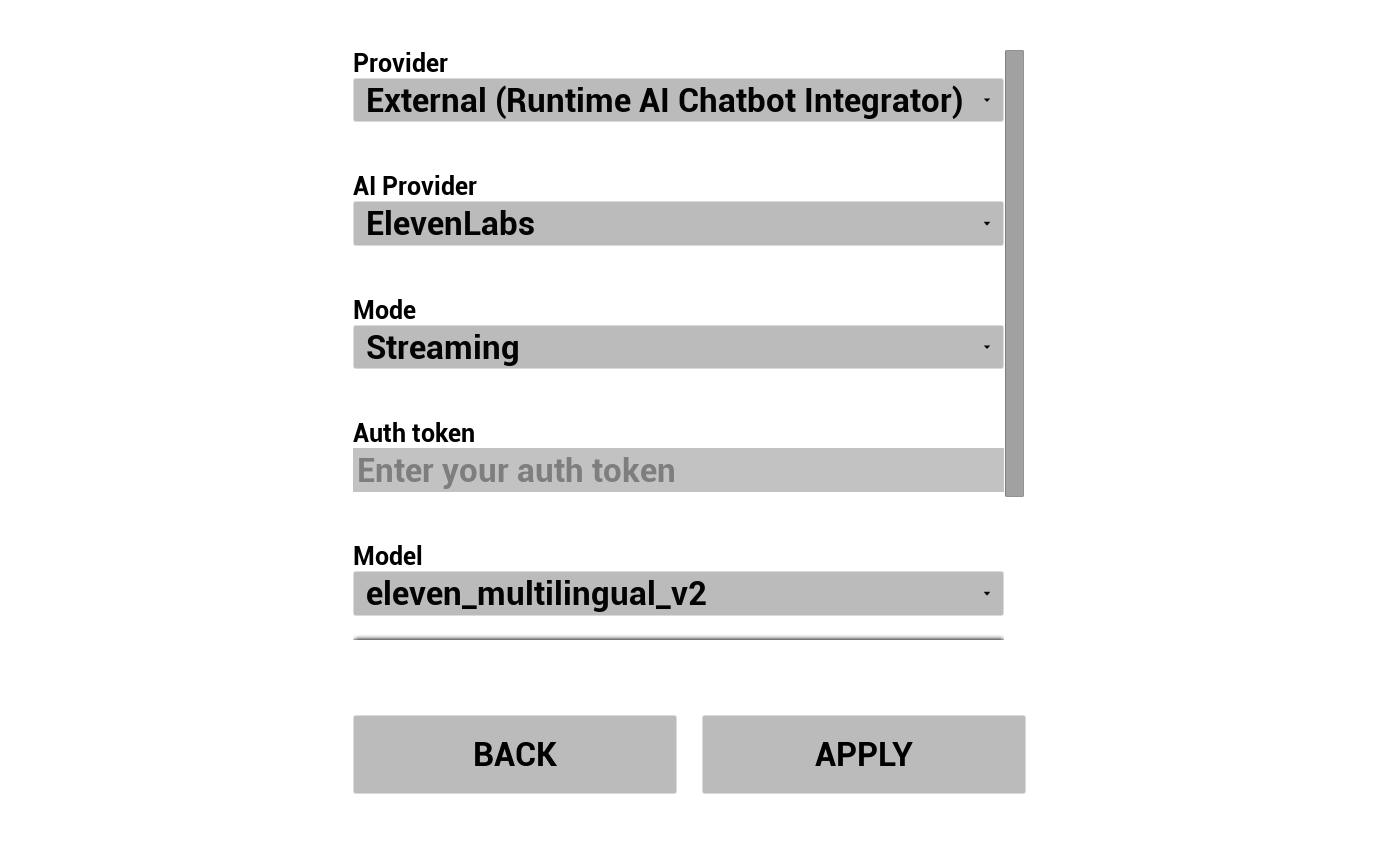
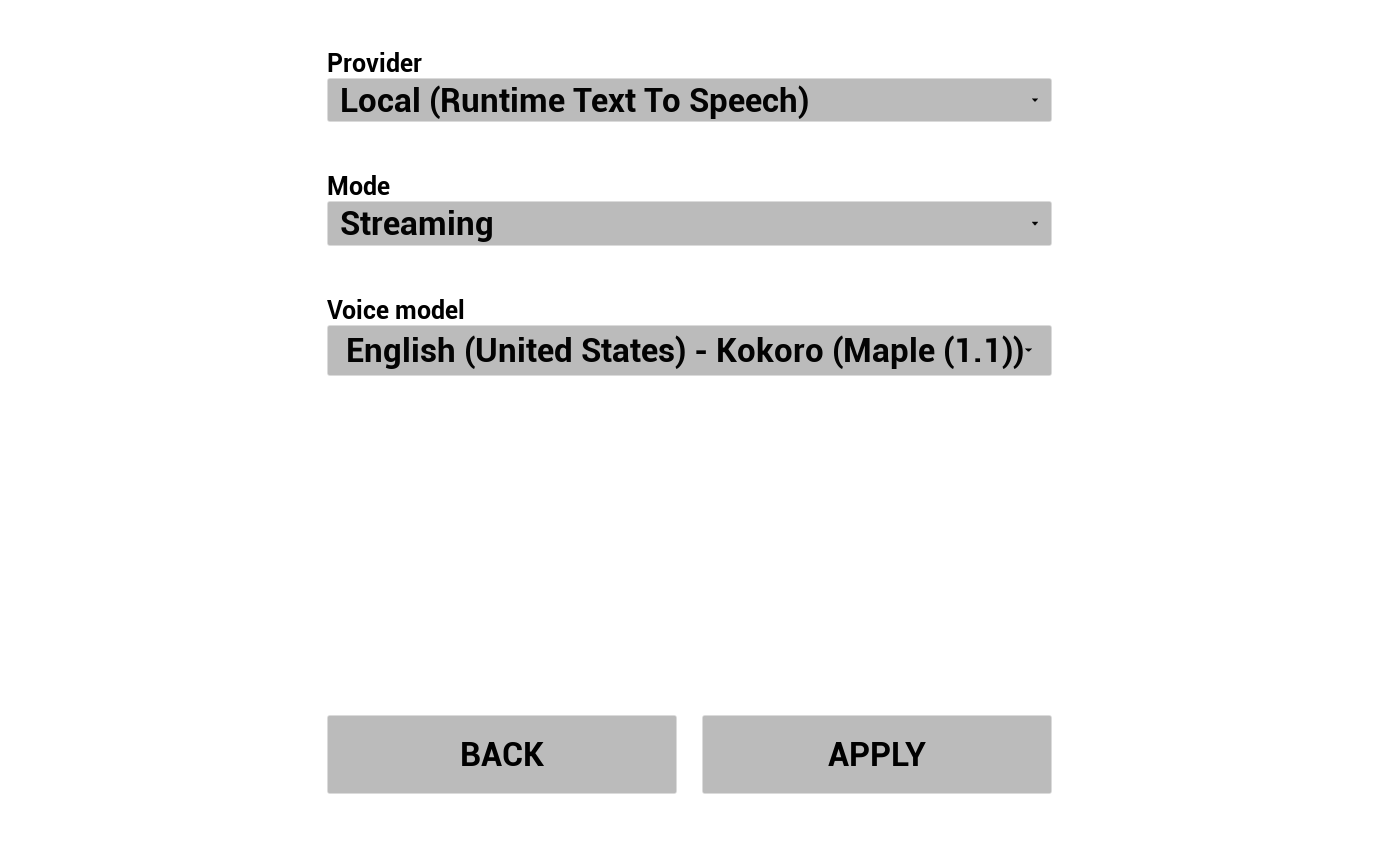
TTSプロバイダーを選択し、音声/モデルを設定してください:
- プロバイダーを選択(OpenAI/ElevenLabs用のRuntime AI Chatbot Integrator、またはローカルPiper/Kokoro用のRuntime Text To Speech)
- モードを選択:通常またはストリーミング(音声が一度に返されるか、合成される際に返されるかを制御)
- 音声/モデルを選択
- プロバイダー固有のパラメータを調整
4. アニメーションを設定する
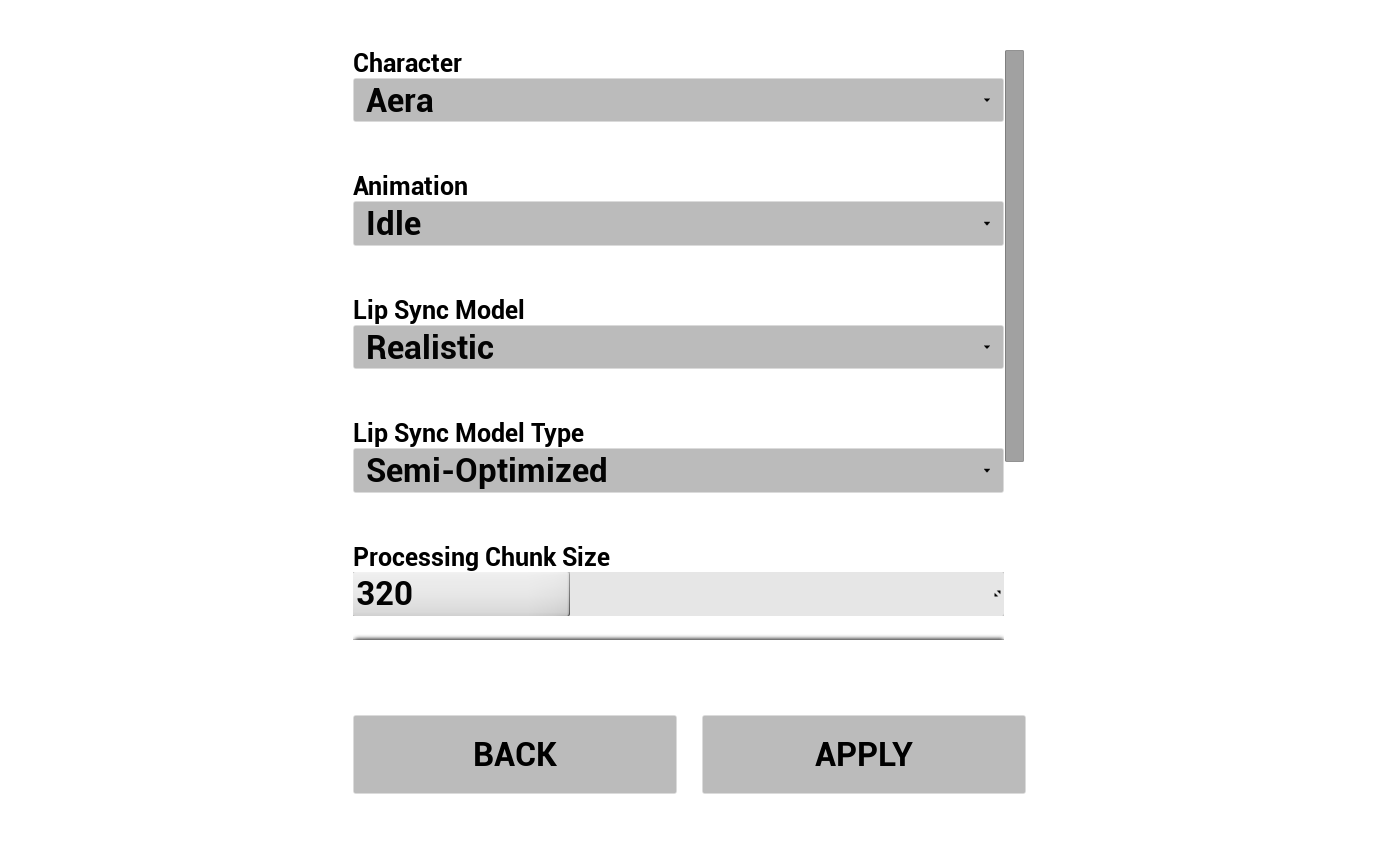
AIアバターのビジュアルをコントロール:
- 事前ダウンロード済みのMetaHumanキャラクター3体(Aera、Ada、Orlando)から選択
- リップシンクモデル(StandardまたはRealistic)を選択
- リップシンクモデルタイプを選択 - Highly Optimized、Semi-Optimized、またはOriginal(モデルタイプを参照)
- 処理チャンクサイズを調整 - リップシンク推論の実行頻度を制御します(処理チャンクサイズを参照)
- CPU負荷が高いときにリップシンクが時間とともにオーディオからさらに遅れる場合、これを480または640に増やしてください。
- MetaHumanの会話中に再生する待機アニメーションを選択します。
エディタでデモを事前設定する
ソース版を使用する場合、エディタで直接デフォルト値を事前に入力できるため、毎回値を再入力する必要はありません。
| What | どこ |
|---|---|
| 一般設定(リップシンクモデル、アイドルアニメーション、キャラクタークラス、音声認識など) | Content/LipSyncSTSGameInstance |
| 外部LLM / 外部TTS設定(Runtime AI Chatbot Integrator) | Content/Modules/RuntimeAIChatbotIntegrator/RuntimeAIChatbotIntegrator_Provider |
| ローカルLLM設定(Runtime Local LLM) | Content/Modules/RuntimeLocalLLM/RuntimeLocalLLM_Provider |
| ローカルTTS設定(Runtime Text To Speech) | Content/Modules/RuntimeTextToSpeech/RuntimeTextToSpeech_Provider |
クロスプラットフォームに関する注意事項
デモで使用されるすべてのプラグインは、Windows、Mac、Linux、iOS、Android、およびAndroidベースのプラットフォーム(Meta Questを含む)をサポートしているため、デモプロジェクトもこれらすべてで動作します。これにより、ゲームやデスクトップキオスクからモバイルアプリ、スタンドアロンVRヘッドセット、セット上のバーチャルプロダクション環境まで、幅広い環境への展開に適しています。
性能の低いデバイス(モバイル、スタンドアロンVR)の場合、以下のことを検討するとよいでしょう:
- 標準のリップシンクモデルをRealisticの代わりに使用してください - モデル比較を参照してください
- Highly Optimizedモデルタイプに切り替えてください
- 処理チャンクサイズを増やしてCPU負荷を軽減してください
- より小さいLLM / TTSモデルを選択してください
プラットフォーム固有の設定については、Android、iOS、Mac、Linuxでの追加セットアップ手順を参照してください。
ピクセルストリーミングサポート
Pixel Streamingでのデモの展開(クリックして展開)
AI会話デモプロジェクトは、Pixel Streaming環境でも動作し、MetaHumanアバターをリモートクライアント(例:Webブラウザ)にストリーミングしながら、クライアント側からユーザーのマイク音声をキャプチャできます。デモに必要な変更は1つだけです。
1. Runtime Audio Importer用のPixel Streaming拡張機能をインストールします。
Runtime Audio Importerプラグインは、Pixel Streamingクライアントからオーディオをキャプチャできるようにする無料の拡張プラグインを提供します。使用しているPixel Streamingインフラストラクチャのバージョンに応じて、次のいずれかをインストールしてください:
- Pixel Streaming 拡張機能(元の Pixel Streaming プラグイン用)、または
- Pixel Streaming 2 拡張機能(新しい Pixel Streaming 2 プラグイン用)
ダウンロードリンクとインストール手順はこちらで確認できます:Pixel Streaming Audio Capture - 拡張プラグインのインストール。
2. LipSyncSTSGameInstance内のキャプチャ可能なサウンドウェーブノードを交換します。
拡張プラグインをインストールした後:
- コンテンツブラウザで
/All/Gameに移動し、LipSyncSTSGameInstanceアセットを開きます。 - イベントグラフ に切り替えます。
- Event Init を見つけ、実行フローに沿って
Create Capturable Sound Wave→Set Capturable Sound Waveのノードのペアを見つけます。 Create Capturable Sound Waveの呼び出しを、対象とする Pixel Streaming インフラストラクチャのバージョンに応じて、Create Pixel Streaming Capturable Sound WaveまたはCreate Pixel Streaming 2 Capturable Sound Waveのいずれかに置き換えます。- その出力を同じ
Set Capturable Sound Waveノードに接続します。
この後、プロジェクトはPixel Streamingにデプロイする準備が整います。音声認識、LLM、TTS、リップシンクはすべて以前と同じように動作しますが、オーディオはローカルマイクではなくリモートクライアントからキャプチャされます。
自作キャラクターを持ち込む
デモプロジェクトには、3体のサンプルMetaHumanキャラクター(Aera、Ada、Orlando)が同梱されていますが、独自のMetaHumanをインポートしてデモで使用することもできます。
📺 ビデオチュートリアル: カスタムMetaHumanキャラクターをデモプロジェクトに追加する
Runtime MetaHuman Lip Syncプラグイン自体は、MetaHuman以外にも多くのキャラクターシステムをサポートしています(ARKitベースのキャラクター、Daz Genesis 8/9、Reallusion CC3/CC4、Mixamo、ReadyPlayerMeなど - カスタムキャラクター設定ガイドを参照)。ゲームNPC、仮想プレゼンター、キオスク案内係、または仮想プロダクション用のデジタルヒューマンを構築している場合でも、このプラグインはあなたのキャラクターパイプラインに適応します。
このデモプロジェクトは、さまざまなオーディオソースにわたってリップシンク機能を紹介することに焦点を当てています。リップシンク自体は、あらゆるストリーミングオーディオ入力、あらゆる言語で動作し、リアルタイムでチャンクごとに処理します。
注目のビデオ
ダウンロード
含まれるもの
このデモでは、基本的なリップシンクのワークフローを紹介します。
- マイク(リアルタイム) - 話すと同時にライブでリップシンク
- マイク(再生) - 先に録音し、その後リップシンク付きで再生
- テキスト読み上げ(ローカル) - ローカル言語モデルによって駆動されるリップシンク
- テキスト読み上げ(外部) - OpenAIまたはElevenLabsの音声によって駆動されるリップシンク(Runtime AI Chatbot IntegratorはGoogle Cloud TTSとAzure TTSにも対応しており、さらにカスタマイズ可能です - リップシンク自体は任意のストリーミング音声ソースで動作します)
- 音声ファイル - インポートした音声ファイルから生成されるリップシンク
必須プラグインとオプションプラグイン
| プラグイン | 目的 | 必須? |
|---|---|---|
| Runtime MetaHuman Lip Sync | リップシンクアニメーション | ✅ 必須 |
| Runtime Audio Importer | オーディオのインポートとキャプチャ | ✅ 必須 |
| Runtime Text To Speech | TTSデモシーン用のローカルTTS | 🔶 オプション |
| Runtime AI Chatbot Integrator | 外部TTSプロバイダー(OpenAI、ElevenLabs) | 🔶 オプション |
バンドル拡張プラグイン
標準リップシンク拡張機能(クリックして展開)
ソース版には、RuntimeMetaHumanLipSync_Standard 拡張機能が Plugins/ にプリバンドルされており、標準リップシンクモデル のサポートが追加されています。バイナリは UE 5.6 用にプリビルドされています。UE 5.7 / 5.8 の場合は、プリビルドアーカイブ(UE 5.7 ・ UE 5.8)を使用するか、ソースからビルドしてください。インストールするには、Plugins/ から既存のフォルダを削除し、その場所にアーカイブの内容を展開します。標準モデルが不要な場合は、フォルダを置き換えずに削除してください。
助けが必要ですか?
デモプロジェクトのセットアップや実行中に問題が発生した場合は、お気軽にお問い合わせください:
カスタム開発のご要望(例:デモを独自のロジックで拡張する、特定のプラットフォームやキャラクターパイプラインに適応させるなど)については、[email protected] までお問い合わせください。