Конфигурация плагина
Конфигурация модели
Для надёжной работы с моделями Realistic и Mood-Enabled Realistic пересоздавайте генератор перед каждым новым воспроизведением аудио, а не используйте один и тот же во время длительных пауз. Подробности см. в разделе Пересоздание генератора в главе «Устранение неполадок».
Стандартная конфигурация модели
Узел Create Runtime Viseme Generator использует настройки по умолчанию, которые хорошо подходят для большинства сценариев. Настройка выполняется через свойства узла смешивания Animation Blueprint.
Параметры настройки Animation Blueprint см. в разделе Lip Sync Configuration ниже.
Конфигурация реалистичной модели
Узел Create Realistic MetaHuman Lip Sync Generator принимает необязательный параметр Configuration, который позволяет настроить поведение генератора:
Тип модели
Настройка Model Type определяет, какую версию реалистичной модели использовать:
| Тип модели | Производительность | Визуальное качество | Обработка шума | Рекомендуемые сценарии использования |
|---|---|---|---|---|
| Сильно оптимизированная (по умолчанию) | Наивысшая производительность, минимальная нагрузка на CPU | Хорошее качество | Возможны заметные движения рта при фоновом шуме или неголосовых звуках | Чистая аудиосреда, сценарии с критичными требованиями к производительности |
| Полуоптимизированная | Хорошая производительность, умеренная нагрузка на CPU | Высокое качество | Лучшая стабильность при зашумлённом аудио | Сбалансированная производительность и качество, смешанные аудиоусловия |
| Оригинальная | Подходит для использования в реальном времени на современных CPU | Наивысшее качество | Наиболее стабильна при фоновом шуме и неголосовых звуках | Высококачественные проекты, зашумлённая аудиосреда, когда требуется максимальная точность |
Настройки производительности
Intra Op Threads: Управляет количеством потоков, используемых для внутренних операций обработки модели.
- 0 (по умолчанию/автоматически): Использует автоматическое определение (обычно 1/4 доступных ядер CPU, максимум 4)
- 1-16: Вручную укажите количество потоков. Более высокие значения могут повысить производительность на многоядерных системах, но потребляют больше CPU
Inter Op Threads: Управляет количеством потоков, используемых для параллельного выполнения различных операций модели.
- 0 (по умолчанию/автоматически): Использует автоматическое определение (обычно 1/8 доступных ядер CPU, максимум 2)
- 1-8: Вручную указать количество потоков. Обычно поддерживается низким для обработки в реальном времени
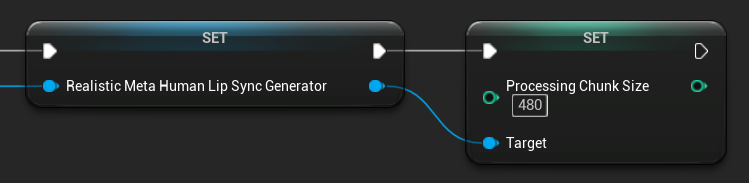
Размер обрабатываемого фрагмента
Размер обрабатываемого фрагмента определяет, сколько сэмплов обрабатывается на каждом шаге инференса. Значение по умолчанию — 160 сэмплов (10 мс аудио при 16 кГц):
- Меньшие значения обеспечивают более частые обновления, но увеличивают нагрузку на CPU
- Большие значения снижают нагрузку на CPU, но могут уменьшить отзывчивость lip sync
- Рекомендуется использовать значения, кратные 160, для оптимального выравнивания
Конфигурация модели с поддержкой настроения
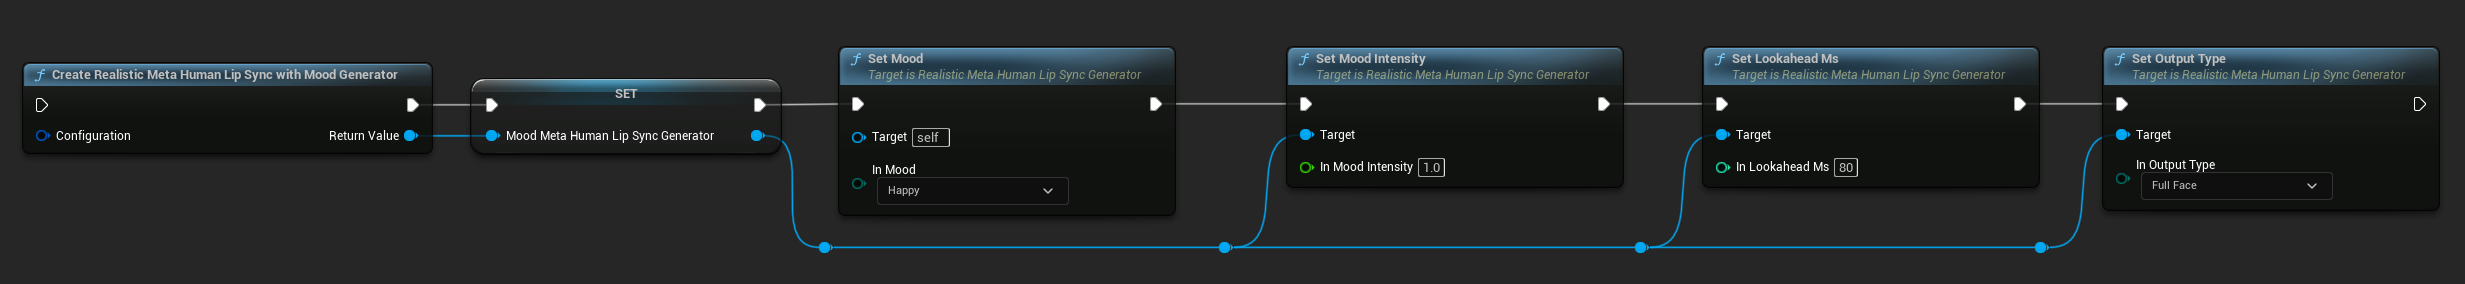
Узел Create Realistic MetaHuman Lip Sync With Mood Generator предоставляет дополнительные параметры конфигурации помимо базовой реалистичной модели:
Базовая конфигурация
Lookahead Ms: Время упреждения в миллисекундах для повышения точности синхронизации губ.
- По умолчанию: 80 мс
- Диапазон: от 20 мс до 200 мс (должно делиться на 20)
- Более высокие значения обеспечивают лучшую синхронизацию, но увеличивают задержку
Тип вывода: Управляет тем, какие лицевые контролы генерируются.
- Всё лицо: Все 81 элемент управления мимикой (брови, глаза, нос, рот, челюсть, язык)
- Только рот: Только элементы управления, связанные со ртом, челюстью и языком
Настройки производительности: Использует те же настройки Intra Op Threads и Inter Op Threads, что и обычная реалистичная модель.
Настройки настроения
Доступные настроения:
- Нейтральный, Радостный, Грустный, Отвращение, Гнев, Удивление, Страх
- Уверенный, Взволнованный, Скучающий, Игривый, Смущённый
Интенсивность настроения: Управляет тем, насколько сильно настроение влияет на анимацию (от 0.0 до 1.0)
Управление настроением в реальном времени
Вы можете настроить параметры настроения во время выполнения с помощью следующих функций:
- Set Mood: Изменить текущий тип настроения
- Set Mood Intensity: Настроить, насколько сильно настроение влияет на анимацию (от 0.0 до 1.0)
- Set Lookahead Ms: Изменить время упреждения для синхронизации
- Set Output Type: Переключение между управлением Full Face и Mouth Only
Руководство по выбору настроения
Выбирайте подходящие настроения в зависимости от вашего контента:
| Mood | Лучше всего подходит | Типичный диапазон интенсивности |
|---|---|---|
| Нейтральный | Обычный разговор, повествование, состояние по умолчанию | 0.5 - 1.0 |
| Радостный | Позитивный контент, жизнерадостный диалог, празднования | 0.6 - 1.0 |
| Грустный | Меланхоличный контент, эмоциональные сцены, мрачные моменты | 0.5 - 0.9 |
| Отвращение | Негативные реакции, неприятный контент, отвержение | 0.4 - 0.8 |
| Гнев | Агрессивный диалог, конфронтационные сцены, раздражение | 0.6 - 1.0 |
| Удивление | Неожиданные события, откровения, шоковые реакции | 0.7 - 1.0 |
| Страх | Угрожающие ситуации, тревога, нервный диалог | 0.5 - 0.9 |
| Уверенный | Профессиональные презентации, диалог лидера, уверенная речь | 0.7 - 1.0 |
| Взволнованный | Энергичный контент, объявления, восторженный диалог | 0.8 - 1.0 |
| Скучающий | Монотонный контент, незаинтересованный диалог, усталая речь | 0.3 - 0.7 |
| Игривый | Непринуждённый разговор, юмор, лёгкое общение | 0.6 - 0.9 |
| Смущённый | Диалог с обилием вопросов, неуверенность, замешательство | 0.4 - 0.8 |
Настройка Animation Blueprint
Настройка Lip Sync
- Стандартная модель
- Реалистичные модели
Узел Blend Runtime MetaHuman Lip Sync имеет параметры конфигурации в своей панели свойств:
| Свойство | По умолчанию | Описание |
|---|---|---|
| Скорость интерполяции | 25 | Управляет тем, насколько быстро движения губ переходят между виземами. Более высокие значения приводят к более быстрым и резким переходам. |
| Время сброса | 0.2 | Длительность в секундах, по истечении которой lip sync сбрасывается. Это полезно, чтобы lip sync не продолжался после остановки аудио. |
Анимация смеха
Вы также можете добавить анимации смеха, которые будут динамически реагировать на смех, обнаруженный в аудио:
- Добавьте узел
Blend Runtime MetaHuman Laughter - Подключите вашу переменную
RuntimeVisemeGeneratorк пинуViseme Generator - Если вы уже используете lip sync:
- Подключите выход узла
Blend Runtime MetaHuman Lip SyncкSource PoseузлаBlend Runtime MetaHuman Laughter - Подключите выход узла
Blend Runtime MetaHuman Laughterк пинуResultузлаOutput Pose
- Подключите выход узла
- Если использовать только смех без синхронизации губ:
- Подключите вашу исходную позу напрямую к
Source PoseузлаBlend Runtime MetaHuman Laughter - Подключите выход к пину
Result
- Подключите вашу исходную позу напрямую к
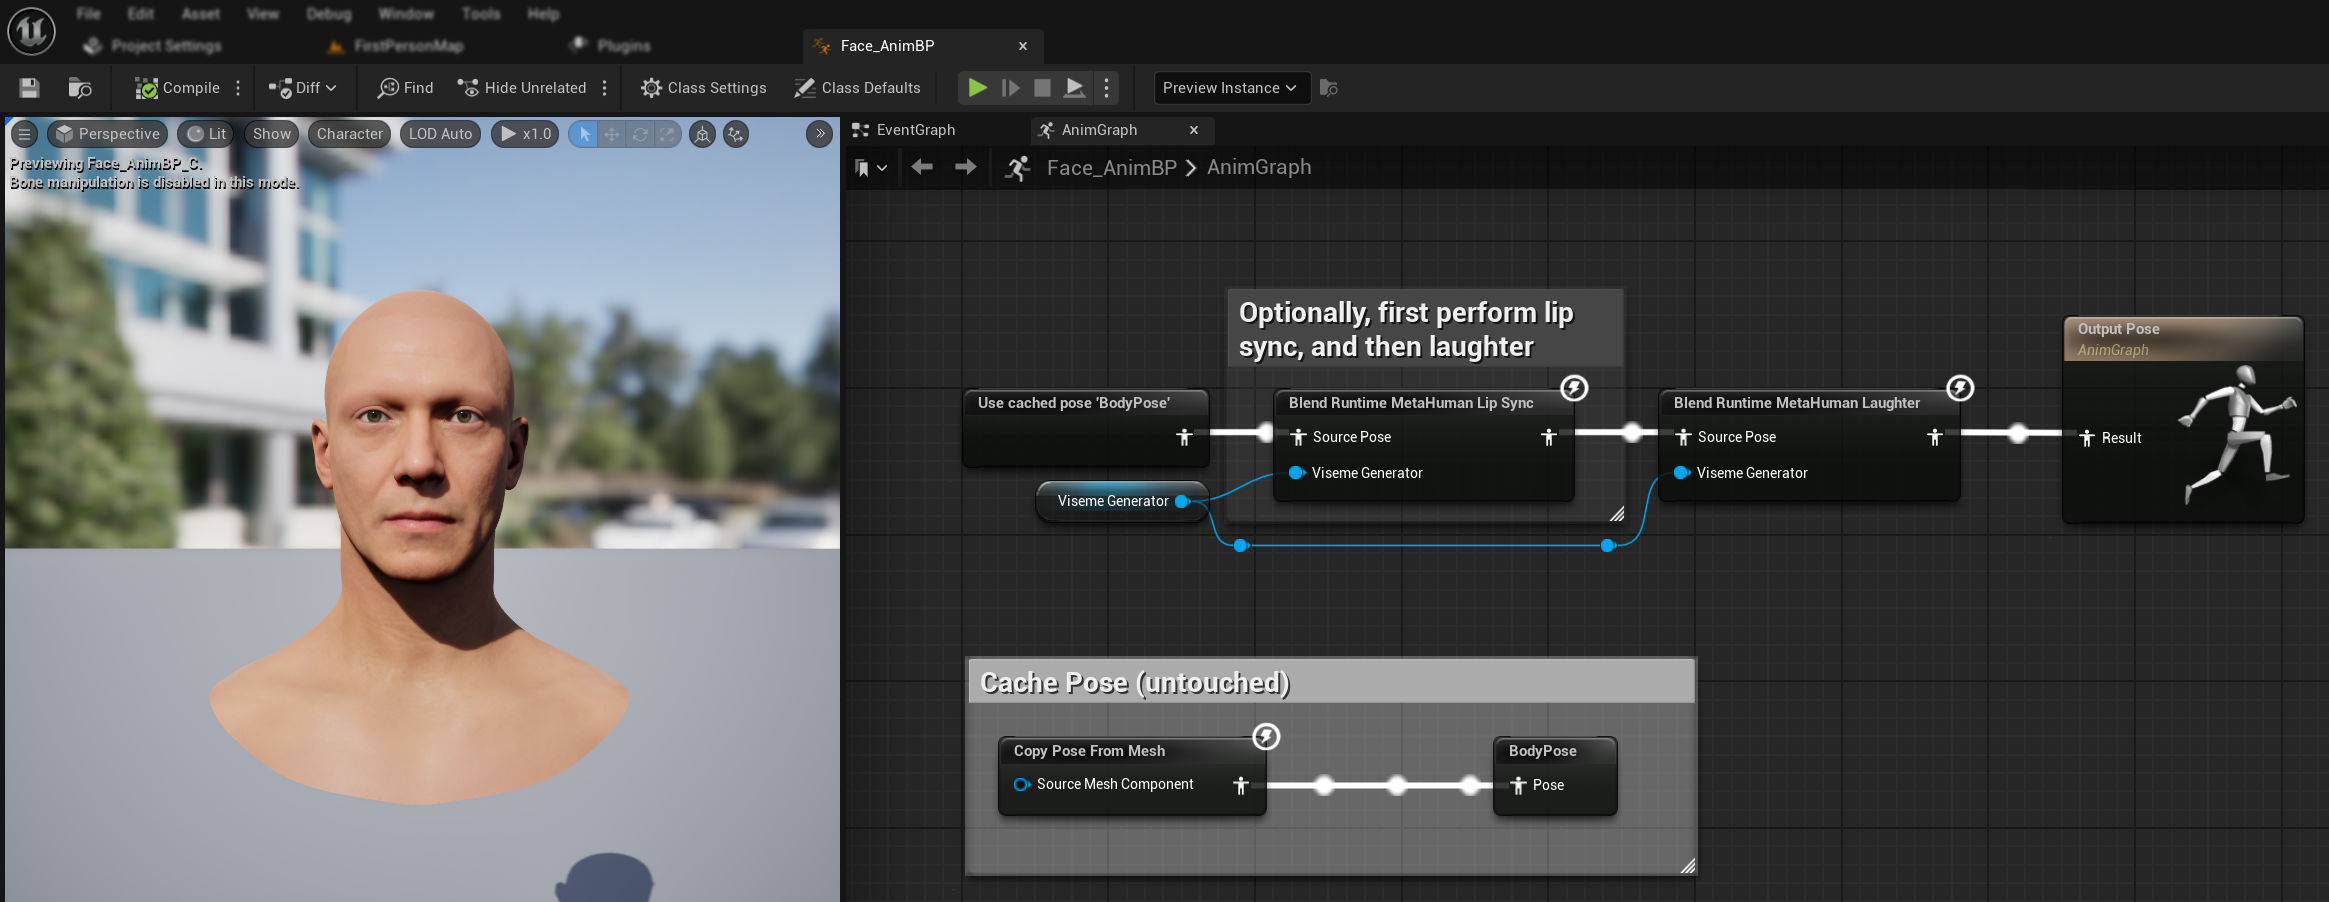
Когда в аудио обнаруживается смех, ваш персонаж будет динамически анимироваться соответствующим образом:
Настройка смеха
Узел Blend Runtime MetaHuman Laughter имеет собственные параметры конфигурации:
| Свойство | По умолчанию | Описание |
|---|---|---|
| Скорость интерполяции | 25 | Управляет скоростью перехода движений губ между анимациями смеха. Более высокие значения приводят к более быстрым и резким переходам. |
| Время сброса | 0.2 | Длительность в секундах, после которой смех сбрасывается. Это полезно для предотвращения продолжения смеха после остановки аудио. |
| Максимальный вес смеха | 0.7 | Масштабирует максимальную интенсивность анимации смеха (0.0 - 1.0). |
Примечание: Обнаружение смеха в настоящее время доступно только в стандартной модели.
Узел Blend Realistic MetaHuman Lip Sync имеет параметры конфигурации в своей панели свойств:
| Свойство | По умолчанию | Описание |
|---|---|---|
| Скорость интерполяции | 30 | Управляет скоростью перехода мимики во время активной речи. Более высокие значения приводят к более быстрым и резким переходам. |
| Скорость интерполяции в состоянии покоя | 15 | Управляет скоростью возврата мимики в состояние покоя/нейтральное состояние. Более низкие значения обеспечивают более плавный и постепенный возврат к исходной позе. |
| Время сброса | 0.2 | Длительность в секундах, по истечении которой lip sync сбрасывается в состояние покоя. Полезно для предотвращения продолжения выражений после остановки аудио. |
| Сохранять состояние покоя | false | Если включено, сохраняет последнее эмоциональное состояние в периоды покоя вместо сброса к нейтральному. |
| Сохранять выражения глаз | true | Управляет тем, сохраняются ли элементы управления мимикой, связанные с глазами, в состоянии покоя. Действует только при включённом параметре «Сохранять состояние покоя». |
| Сохранять выражения бровей | true | Управляет тем, сохраняются ли элементы управления мимикой, связанные с бровями, в состоянии покоя. Действует только при включённом параметре «Сохранять состояние покоя». |
| Сохранять форму рта | false | Управляет тем, сохраняются ли элементы управления формой рта (за исключением движений, связанных с речью, таких как язык и челюсть) в состоянии покоя. Действует только при включённом параметре «Сохранять состояние покоя». |
Сохранение состояния покоя
Функция Preserve Idle State решает вопрос о том, как реалистичная модель обрабатывает периоды тишины. В отличие от стандартной модели, которая использует дискретные виземы и последовательно возвращается к нулевым значениям во время тишины, нейронная сеть реалистичной модели может сохранять тонкое положение лицевых мышц, отличающееся от позы покоя MetaHuman по умолчанию.
Когда включать:
- Сохранение эмоциональных выражений между речевыми сегментами
- Сохранение черт характера персонажа
- Обеспечение визуальной непрерывности в кинематографических сценах
Параметры регионального управления:
- Выражения глаз: Сохраняет прищуривание, расширение и положение век
- Выражения бровей: Сохраняет положение бровей и лба
- Форма рта: Сохраняет общую кривизну рта, позволяя движениям речи (язык, челюсть) сбрасываться
Объединение с существующими анимациями
Предпочитаете смотреть, а не читать? Ознакомьтесь с видеоуроком, посвящённым именно этой настройке.
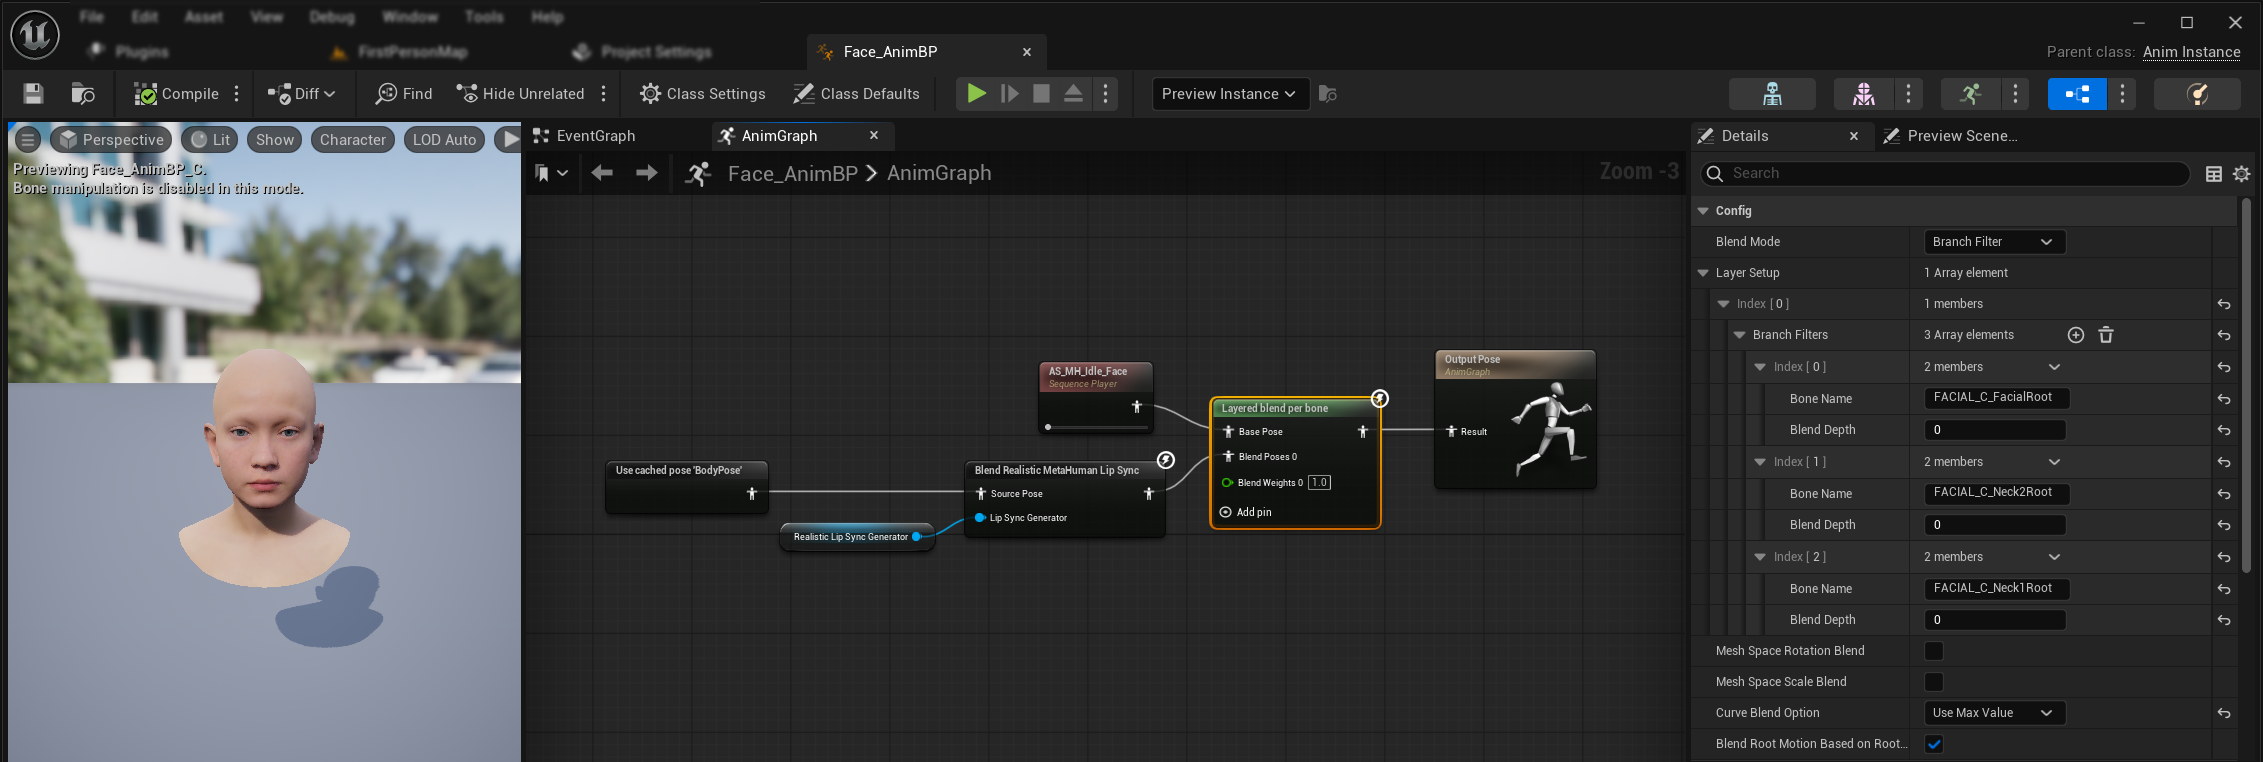
Чтобы применить lip sync и смех вместе с существующими анимациями тела и пользовательскими анимациями лица, не переопределяя их:
Эта настройка применяется к Animation Blueprint лица, поскольку lip sync не является частью Animation Blueprint тела. Для пользовательских анимаций тела (например, торса, рук и других движений тела) просто подключите вашу анимационную последовательность (через Sequence Player) напрямую к выходной позе в Animation Blueprint тела. Дополнительная настройка там не требуется.
- Добавьте узел
Layered blend per boneмежду анимациями тела и финальным выводом. - Настройте слои:
- Добавьте 1 элемент в массив
Layer Setup - Добавьте 3 элемента в
Branch Filtersдля слоя со следующимиBone Name:FACIAL_C_FacialRootFACIAL_C_Neck2RootFACIAL_C_Neck1Root
- Добавьте 1 элемент в массив
- Важно для пользовательских лицевых анимаций: В
Curve Blend Optionвыберите "Use Max Value". Это позволяет пользовательским лицевым анимациям (выражениям, эмоциям и т. д.) корректно накладываться поверх lip sync. - Выполните подключения:
- Ваша пользовательская анимация (обычно
Sequence Playerс нужным ассетом анимационной последовательности) → входBase Pose - Выход лицевой анимации (от узлов lip sync и/или смеха) → вход
Blend Poses 0 - Узел слоистого смешивания → финальная поза
Result
- Ваша пользовательская анимация (обычно
Выбор набора Morph Target
- Стандартная модель
- Реалистичные модели
Стандартная модель использует pose assets, которые по своей природе поддерживают любые соглашения об именовании morph target через настройку пользовательского pose asset. Дополнительная настройка не требуется.
Узел Blend Realistic MetaHuman Lip Sync включает свойство Morph Target Set, которое определяет, какое соглашение об именовании морф-таргетов использовать для лицевой анимации:
| Набор морф-таргетов | Описание | Варианты использования |
|---|---|---|
| MetaHuman (по умолчанию) | Стандартные имена морф-таргетов MetaHuman (например, CTRL_expressions_jawOpen) | Персонажи MetaHuman |
| ARKit | Имена, совместимые с Apple ARKit (например, JawOpen, MouthSmileLeft) | Персонажи на основе ARKit |
Преобразование персонажей в ARKit или MetaHuman Blendshapes
Если ваш персонаж изначально не использует стандартные названия blendshape-ов ARKit, несколько популярных коммерческих систем персонажей можно преобразовать для их создания (или, в случае CC5, сразу преобразовать в нативные blendshape-ы MetaHuman). Это даёт вам доступ к набору Morph Target ARKit или MetaHuman, описанному выше, вместо процесса ручного сопоставления viseme, необходимого для Standard Model. Персонажи CC4 и CC5 обрабатываются здесь по-разному, поскольку персонажи CC5 могут использовать нативный лицевой риг MetaHuman вместо необходимости в конвертации ARKit. CC5: преобразование в blendshapes MetaHuman (рекомендуется) Если ваш персонаж создан в CC5 с HD-профилем лица, он уже использует те же лицевые контролы и скелет, что и MetaHuman, поэтому нет необходимости вручную генерировать ARKit blendshapes. Вместо этого: После импорта выберите опцию MetaHuman Morph Target Set, а не ARKit, поскольку blendshapes персонажа уже используют нативные имена MetaHuman. CC4 (или CC5 без профиля HD): преобразовать в blendshapes ARKit Если вы используете CC4 или персонажа CC5, который не использует профиль HD Facial Profile, вместо этого воспользуйтесь ручной конвертацией ARKit. Перед началом убедитесь, что для вашего персонажа установлен CC4 Extended Facial Profile (а не Standard, Extended-Plus или более новый HD Facial Profile). Сопоставление blendshape в скрипте жёстко привязано к именам слайдеров Extended; в других профилях используются иные соглашения об именовании, и скрипт будет молча пропускать или не находить ожидаемые слайдеры. Скачайте этот скрипт: Откройте скрипт в текстовом редакторе и там, где указано В Character Creator выберите своего персонажа, затем в верхнем меню в разделе Script выберите Load Python. Затем выберите скрипт, который вы только что отредактировали. Скрипт создаст полный набор blendshapes ARKit из стандартных слайдеров Reallusion и экспортирует их в виде OBJ-файлов. Это может занять несколько минут. Теперь вы можете импортировать эти формы, открыв окно Facial Profile Editor. Нажмите кнопку Edit Expressions и в выпадающем списке Batch Import выберите OBJ. Здесь вы можете импортировать папку, на которую ссылались ранее. После этого отобразится список всех ARKit-шейпов. Введите имя в Target Category, например AR_Kit, и нажмите OK. Это создаст новую категорию в разделе Expression. Вы можете отключить все остальные категории. После настройки категории ARKit экспортируйте персонажа в FBX как обычно. Это даст персонажу стандартные 52 blendshape-формы ARKit, которые затем можно использовать с опцией ARKit Morph Target Set выше. Примечание: движение челюсти в риге CC4 частично управляется вращением костей, а не чистыми blendshapes, поэтому FACS-морфы Daz, доступные нативно на Genesis 8.1 и Genesis 9, уже совместимы с ARKit без необходимости переименования. Обычный Genesis 8 (не 8.1) не включает их по умолчанию. Вам нужно либо использовать Genesis 8.1 вместо него, либо добавить отдельный пакет FACS-морфов. Активно поддерживаемый аддон Diffeomorphic (мост между Daz Studio и Blender, не связанный с Daz 3D) — рекомендуемый способ перенести их в Unreal: После экспорта используйте опцию ARKit Morph Target Set выше. Примечание: формы направления взгляда на ресницах и глазных яблоках могут переноситься не полностью, поскольку они управляются иначе, чем основная лицевая сетка, но это не влияет на lip sync, для которого нужны только формы рта и челюсти.Руководства по конвертации Reallusion CC4/CC5 и Daz Genesis 8.1/9 (нажмите, чтобы развернуть)
rl_export_arkit_objs.pyoutput_dir = "path/to/your/target/folder", укажите путь к вашей папке экспорта. Обязательно используйте прямые слэши /.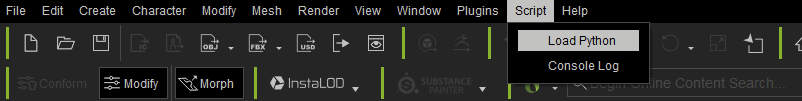
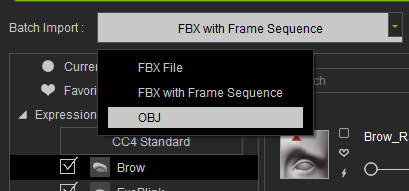
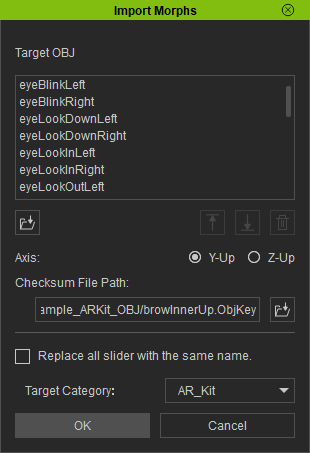
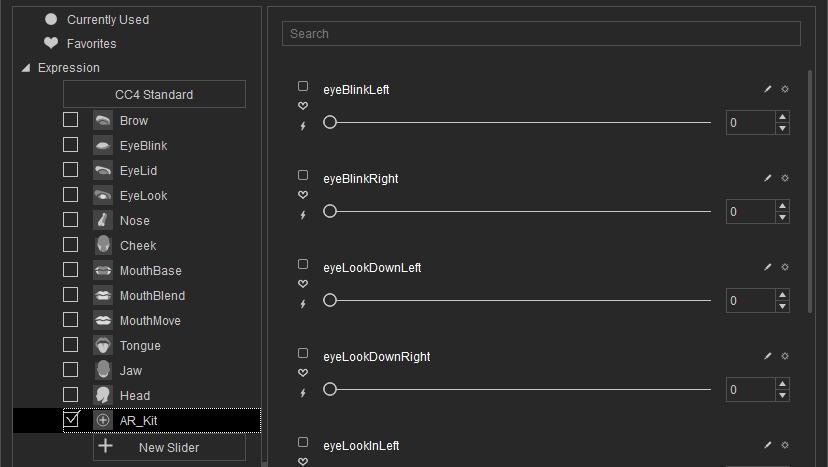
jawOpen может выглядеть слабо или недостаточно убедительно открывать рот после экспорта. Если это происходит, включите Mouth Open as Morph в настройках экспорта FBX — это запекает движение челюсти, управляемое костями, в отдельный blendshape, который можно назначить источником для jawOpen вместо стандартного. Либо аддон cc_blender_tools может провести персонажа через Blender, чтобы исправить это и другие проблемы с формой; см. раздел "Blender Round Trip" в его документации для описания рабочего процесса (в заголовке страницы упоминается Unity, но этот конкретный раздел не зависит от движка).
Тонкая настройка поведения Lip Sync
Масштабирование конкретных кривых Lip Sync
Вы можете ослабить (или усилить) отдельные движения лица, создаваемые lip sync, с помощью узла Modify Curve. Это полезно, когда определённая кривая выглядит слишком выраженной для вашего аудиоконтента или персонажа.
Настройка:
- После вашего узла смешивания lip sync добавьте узел
Modify Curve - Щёлкните правой кнопкой мыши по узлу и выберите Add Curve Pin, затем введите имя кривой, которую хотите масштабировать
- Установите для свойства узла Apply Mode значение Scale
- Задайте параметр Value: значения ниже 1.0 ослабляют движение, значения выше 1.0 усиливают его (например, 0.8 = уменьшение на 20%)
Часто масштабируемые кривые:
| Название кривой | Назначение | Применяется к | Типичная настройка |
|---|---|---|---|
CTRL_expressions_tongueOut | Выдвижение языка вперёд во время определённых фонем | Стандартная модель | 0.8 для уменьшения выдвижения |
CTRL_expressions_jawOpen | Диапазон раскрытия челюсти | Реалистичные модели | 0.9 для уменьшения движения челюсти |
Вы можете добавить несколько выходов кривых к одному узлу Modify Curve, чтобы масштабировать сразу несколько кривых.
Тонкая настройка под конкретное настроение
Для моделей с поддержкой настроений вы можете тонко настроить конкретные эмоциональные выражения:
Управление бровями:
CTRL_expressions_browRaiseInL/CTRL_expressions_browRaiseInR— поднятие внутренней части бровиCTRL_expressions_browRaiseOuterL/CTRL_expressions_browRaiseOuterR— поднятие внешней части бровиCTRL_expressions_browDownL/CTRL_expressions_browDownR— опускание брови
Управление выражением глаз:
CTRL_expressions_eyeSquintInnerL/CTRL_expressions_eyeSquintInnerR— Прищуривание глазCTRL_expressions_eyeCheekRaiseL/CTRL_expressions_eyeCheekRaiseR— Поднятие щёк
Сравнение и выбор моделей
Выбор между моделями
При выборе модели lip sync для вашего проекта учитывайте следующие факторы:
| Рассмотрение | Стандартная модель | Реалистичная модель | Реалистичная модель с поддержкой настроений |
|---|---|---|---|
| Совместимость с персонажами | MetaHumans и все пользовательские типы персонажей | Персонажи MetaHumans (и ARKit) | Персонажи MetaHumans (и ARKit) |
| Визуальное качество | Хороший lip sync с эффективной производительностью | Повышенный реализм с более естественными движениями рта | Повышенный реализм с эмоциональными выражениями |
| Производительность | Оптимизировано для всех платформ, включая мобильные/VR | Повышенные требования к ресурсам | Повышенные требования к ресурсам |
| Возможности | 14 visemes, обнаружение смеха | 81 лицевой контроль, 3 уровня оптимизации | 81 лицевой контроль, 12 настроений, настраиваемый вывод |
| Поддержка платформ | Windows, Android, Quest | Windows, Mac, iOS, Linux, Android, Quest | Windows, Mac, iOS, Linux, Android, Quest |
| Варианты использования | Общие приложения, игры, VR/AR, мобильные устройства | Кинематографические впечатления, взаимодействия крупным планом | Эмоциональное повествование, продвинутое взаимодействие с персонажами |
Совместимость с версиями движка
Если вы используете Unreal Engine 5.2, реалистичные модели могут работать некорректно из-за ошибки в библиотеке ресемплинга UE. Пользователям UE 5.2, которым нужна надёжная функциональность синхронизации губ, следует использовать вместо них стандартную модель.
Эта проблема характерна только для UE 5.2 и не затрагивает другие версии движка.
Рекомендации по производительности
- Для большинства проектов Standard Model обеспечивает отличный баланс качества и производительности
- Используйте Realistic Model, когда вам нужна максимальная визуальная точность для персонажей MetaHuman
- Используйте Mood-Enabled Realistic Model, когда управление эмоциональным выражением важно для вашего приложения
- Учитывайте производительные возможности вашей целевой платформы при выборе между моделями
- Тестируйте различные уровни оптимизации, чтобы найти наилучший баланс для вашего конкретного случая использования
Устранение неполадок
Распространённые проблемы
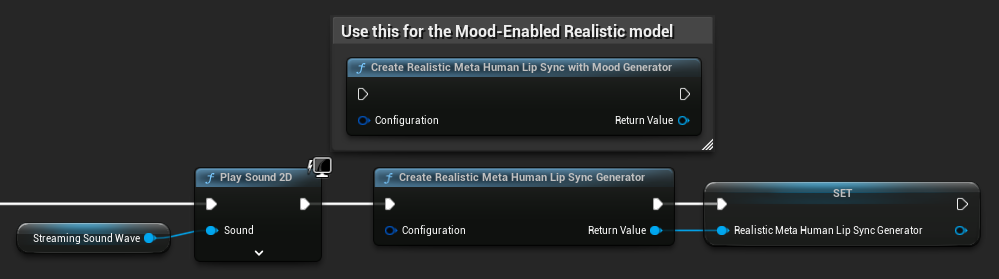
Пересоздание генератора для реалистичных моделей: Для надёжной и стабильной работы с реалистичными моделями рекомендуется пересоздавать генератор каждый раз, когда вы хотите подать новые аудиоданные после периода бездействия. Это связано с поведением среды выполнения ONNX, из-за которого синхронизация губ может перестать работать при повторном использовании генераторов после периодов тишины.
Например, вы можете пересоздавать генератор синхронизации губ при каждом запуске воспроизведения, например, каждый раз, когда вы вызываете Play Sound 2D или используете любой другой метод для запуска воспроизведения звуковой волны и синхронизации губ:
Расположение плагина для интеграции Runtime Text To Speech: При использовании Runtime MetaHuman Lip Sync вместе с Runtime Text To Speech (оба плагина используют ONNX Runtime) вы можете столкнуться с проблемами, если плагины установлены в папке Marketplace движка. Чтобы исправить это:
- Найдите оба плагина в папке установки UE по пути
\Engine\Plugins\Marketplace(например,C:\Program Files\Epic Games\UE_5.6\Engine\Plugins\Marketplace) - Переместите обе папки
RuntimeMetaHumanLipSyncиRuntimeTextToSpeechв папкуPluginsвашего проекта - Если в вашем проекте нет папки
Plugins, создайте её в том же каталоге, где находится файл.uproject - Перезапустите Unreal Editor
Это решает проблемы совместимости, которые могут возникать, когда несколько плагинов на основе ONNX Runtime загружаются из каталога Marketplace движка.
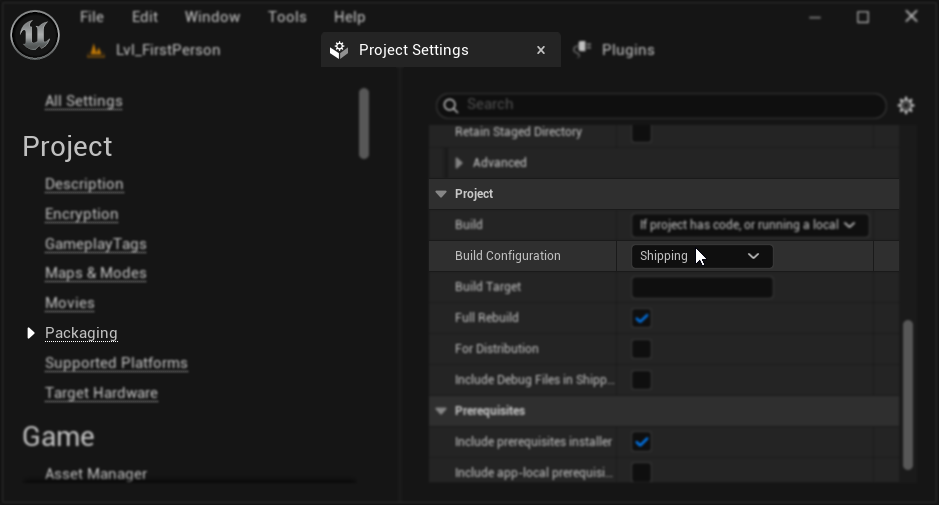
Настройка упаковки (Windows): Если синхронизация губ работает неправильно в вашем упакованном проекте на Windows, убедитесь, что вы используете конфигурацию сборки Shipping, а не Development. Конфигурация Development может вызывать проблемы с runtime ONNX для реалистичных моделей в упакованных сборках.
Чтобы исправить это:
- В настройках проекта → Упаковка установите конфигурацию сборки в Shipping
- Переупакуйте проект
В некоторых проектах, состоящих только из Blueprint, Unreal Engine может по-прежнему собираться в конфигурации Development, даже если выбрана Shipping. Если это происходит, преобразуйте проект в проект C++, добавив хотя бы один класс C++ (он может быть пустым). Для этого перейдите в Tools → New C++ Class в меню редактора UE и создайте пустой класс. Это заставит проект корректно собираться в конфигурации Shipping. Ваш проект может оставаться Blueprint-only по функциональности, класс C++ нужен только для правильной конфигурации сборки.
Ухудшение отзывчивости Lip Sync: Если вы замечаете, что Lip Sync со временем становится менее отзывчивым при использовании Streaming Sound Wave или Capturable Sound Wave, это может быть вызвано накоплением памяти. По умолчанию память перераспределяется каждый раз при добавлении нового аудио. Чтобы предотвратить эту проблему, периодически вызывайте функцию ReleaseMemory для освобождения накопленной памяти, например, примерно каждые 30 секунд.
Оптимизация производительности:
- Настройте размер обрабатываемого фрагмента для моделей Realistic в соответствии с вашими требованиями к производительности
- Используйте подходящее количество потоков для вашего целевого оборудования
- Рассмотрите использование типа вывода Mouth Only для моделей с поддержкой настроения, когда полная лицевая анимация не требуется