如何使用该插件
Runtime Text To Speech 插件使用可下载的语音模型将文本合成为语音。这些模型在编辑器内的插件设置中进行管理、下载,并打包以供运行时使用。请按照以下步骤开始使用。
编辑器端
按照此处的说明为您的项目下载合适的语音模型。您可以同时下载多个语音模型。
运行时端
使用 CreateRuntimeTextToSpeech 函数创建合成器。请确保您保持对它的引用(例如,在 Blueprints 中作为单独的变量,或在 C++ 中作为 UPROPERTY),以防止其被垃圾回收。
- Blueprint
- C++
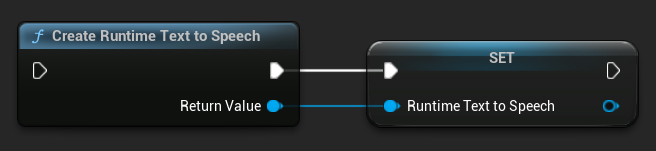
// Create the Runtime Text To Speech synthesizer in C++
URuntimeTextToSpeech* Synthesizer = URuntimeTextToSpeech::CreateRuntimeTextToSpeech();
// Ensure the synthesizer is referenced correctly to prevent garbage collection (e.g. as a UPROPERTY)
语音合成
该插件提供两种文本转语音合成模式:
- 常规文本转语音:合成整个文本并在完成后返回完整的音频
- 流式文本转语音:在音频生成时提供音频块,允许实时处理
每种模式支持两种选择语音模型的方法:
- 按名称:通过名称选择语音模型(推荐用于 UE 5.4+)
- 按对象:通过直接引用选择语音模型(推荐用于 UE 5.3 及更早版本)
常规文本转语音
按名称
- Blueprint
- C++
从 UE 5.4 开始,Text To Speech (By Name) 函数在 Blueprints 中使用更加方便。它允许您从已下载模型的下列列表中选择语音模型。在 UE 5.3 及以下版本中,此下拉列表不会出现,因此如果您使用的是旧版本,则需要手动遍历 GetDownloadedVoiceModels 返回的语音模型数组来选择所需的模型。
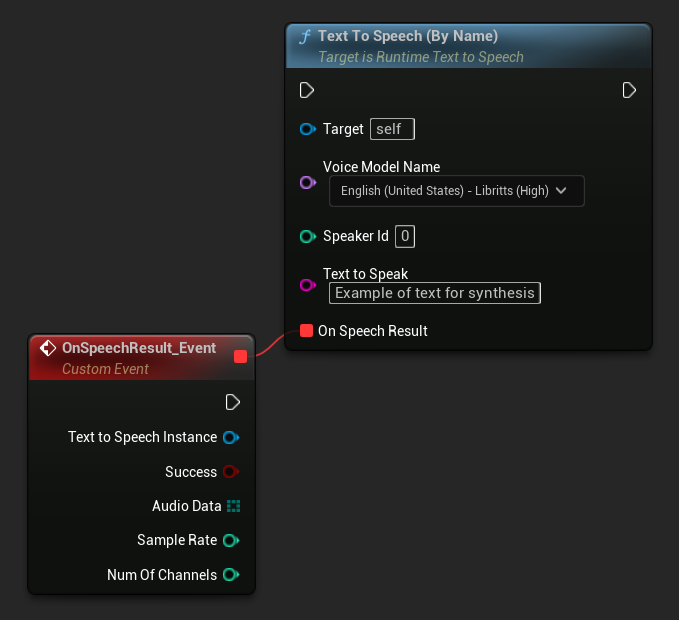
在 C++ 中,由于缺少下拉列表,语音模型的选择可能稍微复杂一些。您可以使用 GetDownloadedVoiceModelNames 函数检索已下载语音模型的名称并选择所需的模型。之后,您可以调用 TextToSpeechByName 函数使用所选语音模型名称合成文本。
    // Assuming "Synthesizer" is a valid and referenced URuntimeTextToSpeech object (ensure it is not eligible for garbage collection during the callback)

    TArray<FName> DownloadedVoiceNames = URuntimeTTSLibrary::GetDownloadedVoiceModelNames();

    // If there are downloaded voice models, use the first one to synthesize text, just as an example
    if (DownloadedVoiceNames.Num() > 0)
    {
    	const FName& VoiceName = DownloadedVoiceNames[0]; // Select the first available voice model
    	Synthesizer->TextToSpeechByName(VoiceName, 0, TEXT("Text example 123"), FOnTTSResultDelegateFast::CreateLambda([](URuntimeTextToSpeech* TextToSpeechInstance, bool bSuccess, const TArray<uint8>& AudioData, int32 SampleRate, int32 NumChannels)
    	{
    		UE_LOG(LogTemp, Log, TEXT("TextToSpeech result: %s, AudioData size: %d, SampleRate: %d, NumChannels: %d"), bSuccess ? TEXT("Success") : TEXT("Failed"), AudioData.Num(), SampleRate, NumChannels);
    	}));
    	return;
    }
通过对象 (By Object)
- Blueprint
- C++
Text To Speech (By Object) 函数适用于所有版本的 Unreal Engine,但会将语音模型显示为资源引用的下拉列表,这种方式不太直观。此方法适用于 UE 5.3 及更早版本,或者您的项目因任何原因需要直接引用语音模型资源。
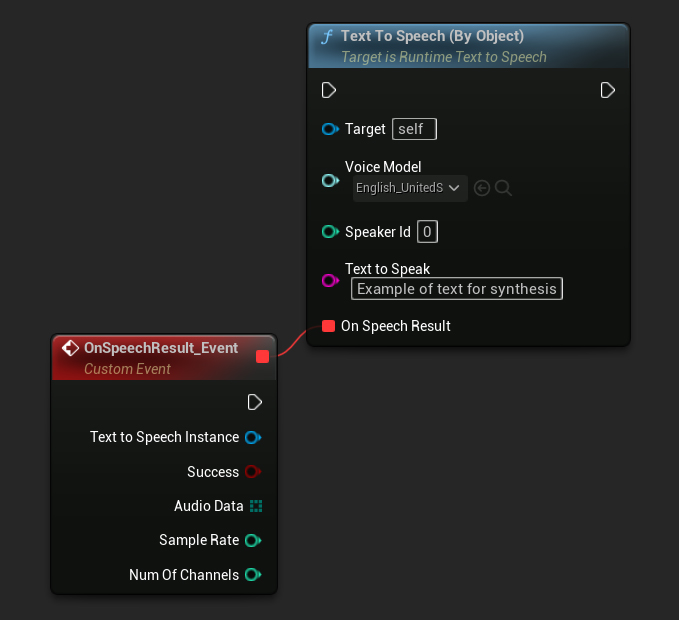
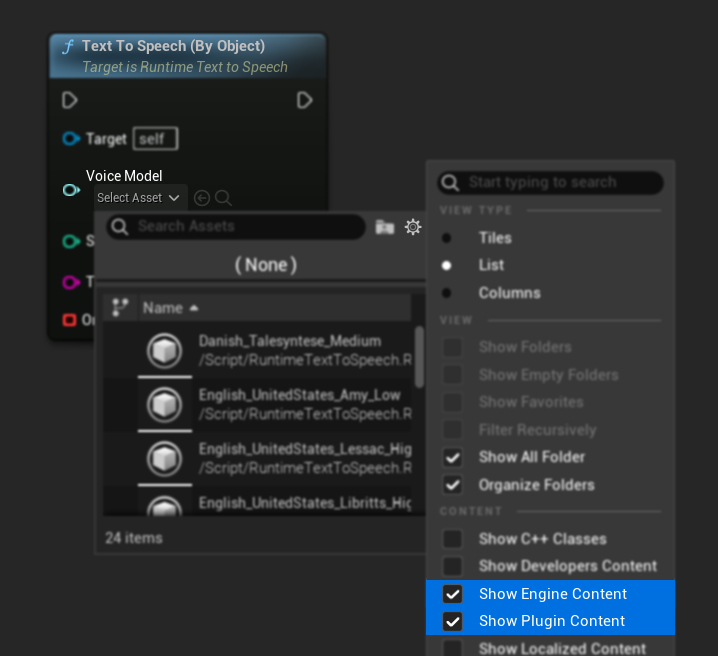
如果您已下载模型但看不到它们,请打开 Voice Model 下拉菜单,单击设置(齿轮图标),并启用 Show Plugin Content 和 Show Engine Content 以使模型可见。
在 C++ 中,由于缺少下拉列表,选择语音模型可能稍微复杂一些。您可以使用 GetDownloadedVoiceModelNames 函数来检索已下载语音模型的名称并选择您需要的模型。然后,您可以调用 GetVoiceModelFromName 函数来获取语音模型对象,并将其传递给 TextToSpeechByObject 函数以合成文本。
    // Assuming "Synthesizer" is a valid and referenced URuntimeTextToSpeech object (ensure it is not eligible for garbage collection during the callback)

    TArray<FName> DownloadedVoiceNames = URuntimeTTSLibrary::GetDownloadedVoiceModelNames();

	// If there are downloaded voice models, use the first one to synthesize text, for example
	if (DownloadedVoiceNames.Num() > 0)
	{
		const FName& VoiceName = DownloadedVoiceNames[0]; // Select the first available voice model
		TSoftObjectPtr<URuntimeTTSModel> VoiceModel;
		if (!URuntimeTTSLibrary::GetVoiceModelFromName(VoiceName, VoiceModel))
		{
			UE_LOG(LogTemp, Error, TEXT("Failed to get voice model from name: %s"), *VoiceName.ToString());
			return;
		}
		Synthesizer->TextToSpeechByObject(VoiceModel, 0, TEXT("Text example 123"), FOnTTSResultDelegateFast::CreateLambda([](URuntimeTextToSpeech* TextToSpeechInstance, bool bSuccess, const TArray<uint8>& AudioData, int32 SampleRate, int32 NumChannels)
		{
			UE_LOG(LogTemp, Log, TEXT("TextToSpeech result: %s, AudioData size: %d, SampleRate: %d, NumChannels: %d"), bSuccess ? TEXT("Success") : TEXT("Failed"), AudioData.Num(), SampleRate, NumChannels);
		}));
		return;
	}
流式文本转语音
对于较长的文本,或者当您希望在音频数据生成时实时处理它时,您可以使用流式版本的文本转语音函数:
Streaming Text To Speech (By Name)(C++ 中为StreamingTextToSpeechByName)Streaming Text To Speech (By Object)(C++ 中为StreamingTextToSpeechByObject)
这些函数在音频数据生成时以数据块的形式提供,允许立即处理而无需等待整个合成过程完成。这对于各种应用非常有用,例如实时音频播放、实时可视化,或者任何需要增量处理语音数据的场景。
按名称流式处理
- Blueprint
- C++
Streaming Text To Speech (By Name) 函数的工作方式与常规版本类似,但通过 On Speech Chunk 委托以数据块的形式提供音频。
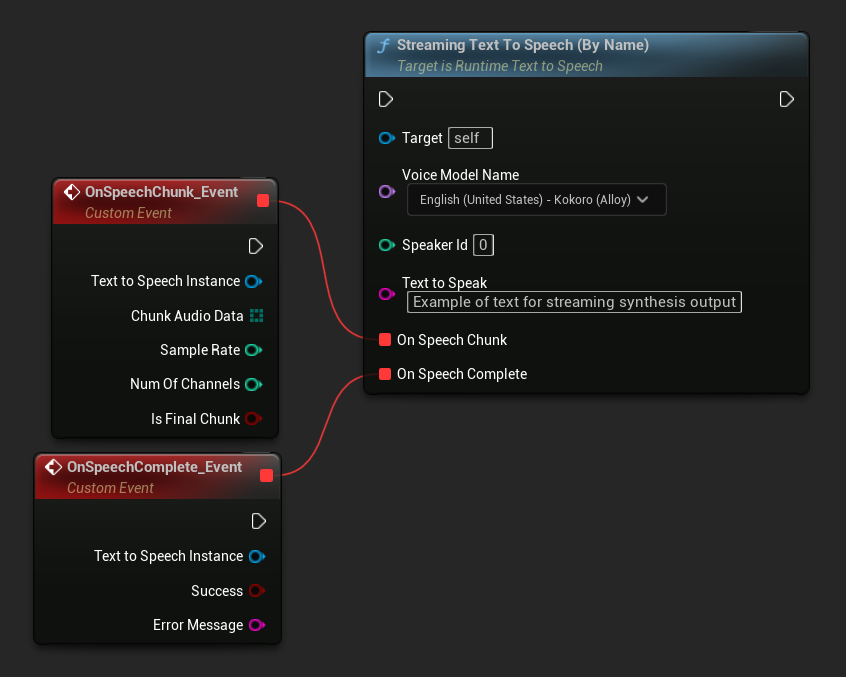
    // Assuming "Synthesizer" is a valid and referenced URuntimeTextToSpeech object

    TArray<FName> DownloadedVoiceNames = URuntimeTTSLibrary::GetDownloadedVoiceModelNames();

    if (DownloadedVoiceNames.Num() > 0)
    {
        const FName& VoiceName = DownloadedVoiceNames[0]; // Select the first available voice model

        Synthesizer->StreamingTextToSpeechByName(
            VoiceName,
            0,
            TEXT("This is a long text that will be synthesized in chunks."),
            FOnTTSStreamingChunkDelegateFast::CreateLambda([](URuntimeTextToSpeech* TextToSpeechInstance, const TArray<uint8>& ChunkAudioData, int32 SampleRate, int32 NumOfChannels, bool bIsFinalChunk)
            {
                // Process each chunk of audio data as it becomes available
                UE_LOG(LogTemp, Log, TEXT("Received chunk %d with %d bytes of audio data. Sample rate: %d, Channels: %d, Is Final: %s"),
                    ChunkIndex, ChunkAudioData.Num(), SampleRate, NumOfChannels, bIsFinalChunk ? TEXT("Yes") : TEXT("No"));

                // You can start processing/playing this chunk immediately
            }),
            FOnTTSStreamingCompleteDelegateFast::CreateLambda([](URuntimeTextToSpeech* TextToSpeechInstance, bool bSuccess, const FString& ErrorMessage)
            {
                // Called when the entire synthesis is complete or if it fails
                if (bSuccess)
                {
                    UE_LOG(LogTemp, Log, TEXT("Streaming synthesis completed successfully"));
                }
                else
                {
                    UE_LOG(LogTemp, Error, TEXT("Streaming synthesis failed: %s"), *ErrorMessage);
                }
            })
        );
    }
按对象流式传输
- Blueprint
- C++
Streaming Text To Speech (By Object) 函数提供相同的流式功能,但接受一个语音模型对象引用。
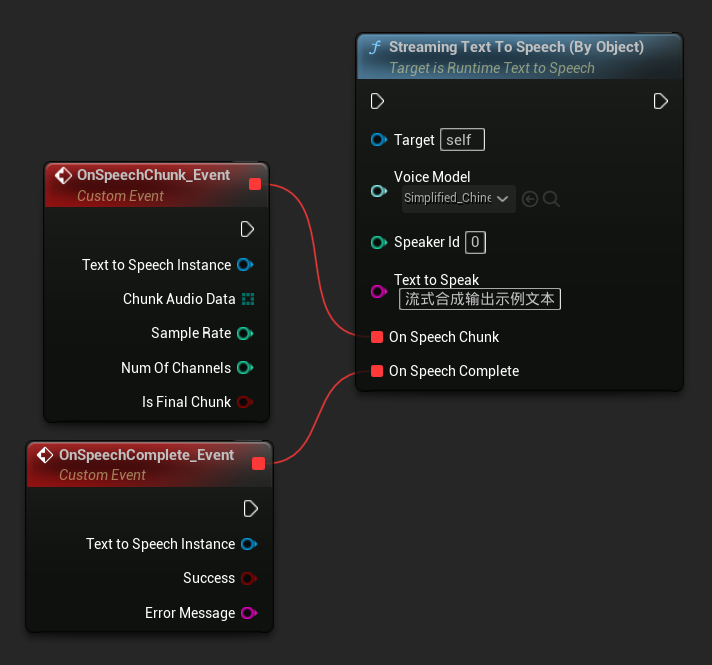
    // Assuming "Synthesizer" is a valid and referenced URuntimeTextToSpeech object

    TArray<FName> DownloadedVoiceNames = URuntimeTTSLibrary::GetDownloadedVoiceModelNames();

    if (DownloadedVoiceNames.Num() > 0)
    {
        const FName& VoiceName = DownloadedVoiceNames[0]; // Select the first available voice model
        TSoftObjectPtr<URuntimeTTSModel> VoiceModel;

        if (!URuntimeTTSLibrary::GetVoiceModelFromName(VoiceName, VoiceModel))
        {
            UE_LOG(LogTemp, Error, TEXT("Failed to get voice model from name: %s"), *VoiceName.ToString());
            return;
        }

        Synthesizer->StreamingTextToSpeechByObject(
            VoiceModel,
            0,
            TEXT("This is a long text that will be synthesized in chunks."),
            FOnTTSStreamingChunkDelegateFast::CreateLambda([](URuntimeTextToSpeech* TextToSpeechInstance, const TArray<uint8>& ChunkAudioData, int32 SampleRate, int32 NumOfChannels, bool bIsFinalChunk)
            {
                // Process each chunk of audio data as it becomes available
                UE_LOG(LogTemp, Log, TEXT("Received chunk %d with %d bytes of audio data. Sample rate: %d, Channels: %d, Is Final: %s"),
                    ChunkIndex, ChunkAudioData.Num(), SampleRate, NumOfChannels, bIsFinalChunk ? TEXT("Yes") : TEXT("No"));

                // You can start processing/playing this chunk immediately
            }),
            FOnTTSStreamingCompleteDelegateFast::CreateLambda([](URuntimeTextToSpeech* TextToSpeechInstance, bool bSuccess, const FString& ErrorMessage)
            {
                // Called when the entire synthesis is complete or if it fails
                if (bSuccess)
                {
                    UE_LOG(LogTemp, Log, TEXT("Streaming synthesis completed successfully"));
                }
                else
                {
                    UE_LOG(LogTemp, Error, TEXT("Streaming synthesis failed: %s"), *ErrorMessage);
                }
            })
        );
    }
音频播放
- 常规播放
- 流式播放
对于常规(非流式)文本转语音,On Speech Result 委托提供合成的音频作为 PCM 数据(以 Blueprints 中的字节数组或 C++ 中的 TArray<uint8> 格式),以及 Sample Rate(采样率)和 Num Of Channels(通道数)。
对于播放,建议使用 Runtime Audio Importer 插件将原始音频数据转换为可播放的音效波形。
- Blueprint
- C++
以下是合成文本并播放音频的 Blueprint 节点示例(可复制节点):
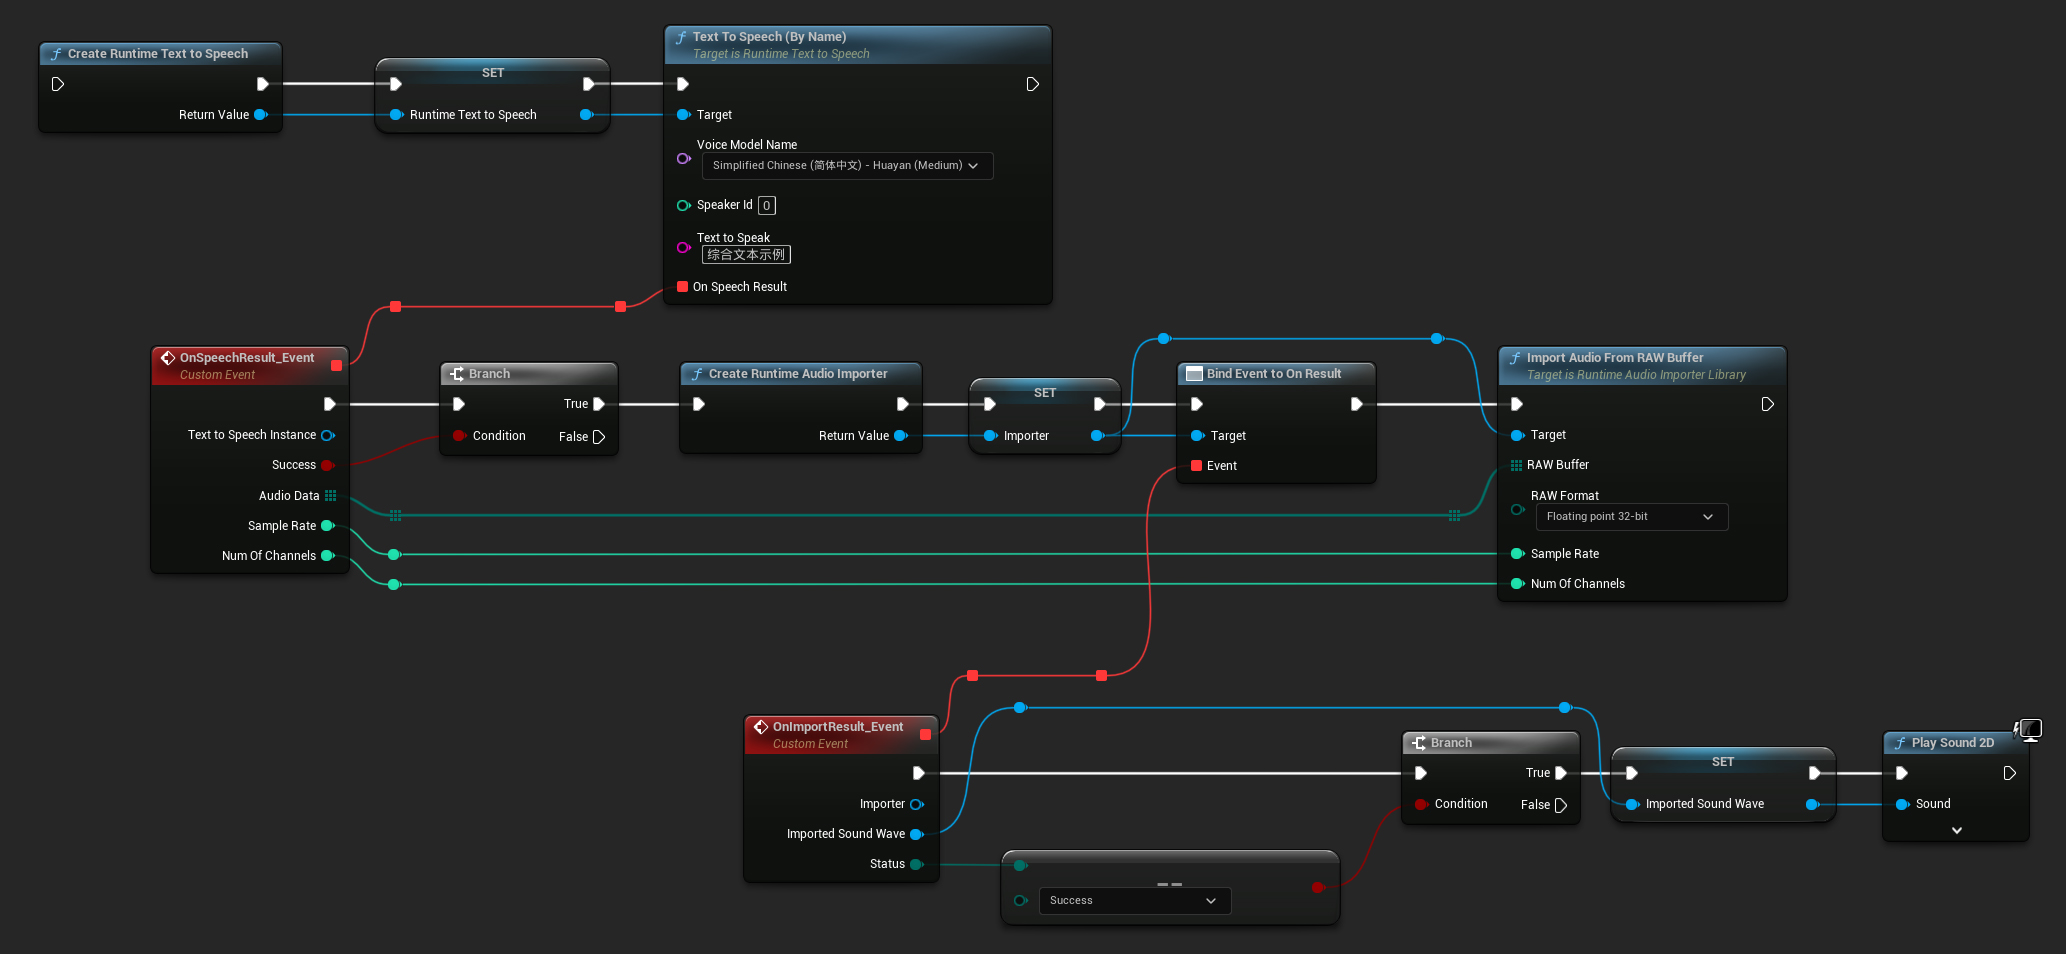
以下是在 C++ 中合成文本并播放音频的示例:
        // Assuming "Synthesizer" is a valid and referenced URuntimeTextToSpeech object (ensure it is not eligible for garbage collection during the callback)
        // Ensure "this" is a valid and referenced UObject (must not be eligible for garbage collection during the callback)

        TArray<FName> DownloadedVoiceNames = URuntimeTTSLibrary::GetDownloadedVoiceModelNames();

        // If there are downloaded voice models, use the first one to synthesize text, for example
        if (DownloadedVoiceNames.Num() > 0)
        {
            const FName& VoiceName = DownloadedVoiceNames[0]; // Select the first available voice model
            Synthesizer->TextToSpeechByName(VoiceName, 0, TEXT("Text example 123"), FOnTTSResultDelegateFast::CreateLambda([this](URuntimeTextToSpeech* TextToSpeechInstance, bool bSuccess, const TArray<uint8>& AudioData, int32 SampleRate, int32 NumOfChannels)
            {
                if (!bSuccess)
                {
                    UE_LOG(LogTemp, Error, TEXT("TextToSpeech failed"));
                    return;
                }

                // Create the Runtime Audio Importer to process the audio data
                URuntimeAudioImporterLibrary* RuntimeAudioImporter = URuntimeAudioImporterLibrary::CreateRuntimeAudioImporter();

                // Prevent the RuntimeAudioImporter from being garbage collected by adding it to the root (you can also use a UPROPERTY, TStrongObjectPtr, etc.)
                RuntimeAudioImporter->AddToRoot();

                RuntimeAudioImporter->OnResultNative.AddWeakLambda(RuntimeAudioImporter, [this](URuntimeAudioImporterLibrary* Importer, UImportedSoundWave* ImportedSoundWave, ERuntimeImportStatus Status)
                {
                    // Once done, remove it from the root to allow garbage collection
                    Importer->RemoveFromRoot();

                    if (Status != ERuntimeImportStatus::SuccessfulImport)
                    {
                        UE_LOG(LogTemp, Error, TEXT("Failed to import audio, status: %s"), *UEnum::GetValueAsString(Status));
                        return;
                    }

                    // Play the imported sound wave (ensure a reference is kept to prevent garbage collection)
                    UGameplayStatics::PlaySound2D(GetWorld(), ImportedSoundWave);
                });

                RuntimeAudioImporter->ImportAudioFromRAWBuffer(AudioData, ERuntimeRAWAudioFormat::Float32, SampleRate, NumOfChannels);
            }));
            return;
        }
对于流式文本转语音,您将收到分块的音频数据,格式为浮点型 PCM 数据(在 Blueprints 中作为字节数组,在 C++ 中作为 TArray<uint8>),同时附带 采样率 和 声道数。每个数据块在可用时可以立即处理。
对于实时播放,建议使用 Runtime Audio Importer 插件的 流式音波,该组件专为流式音频播放或实时处理而设计。
- Blueprint
- C++
以下是流式文本转语音和播放音频的 Blueprint 节点示例(可复制节点):
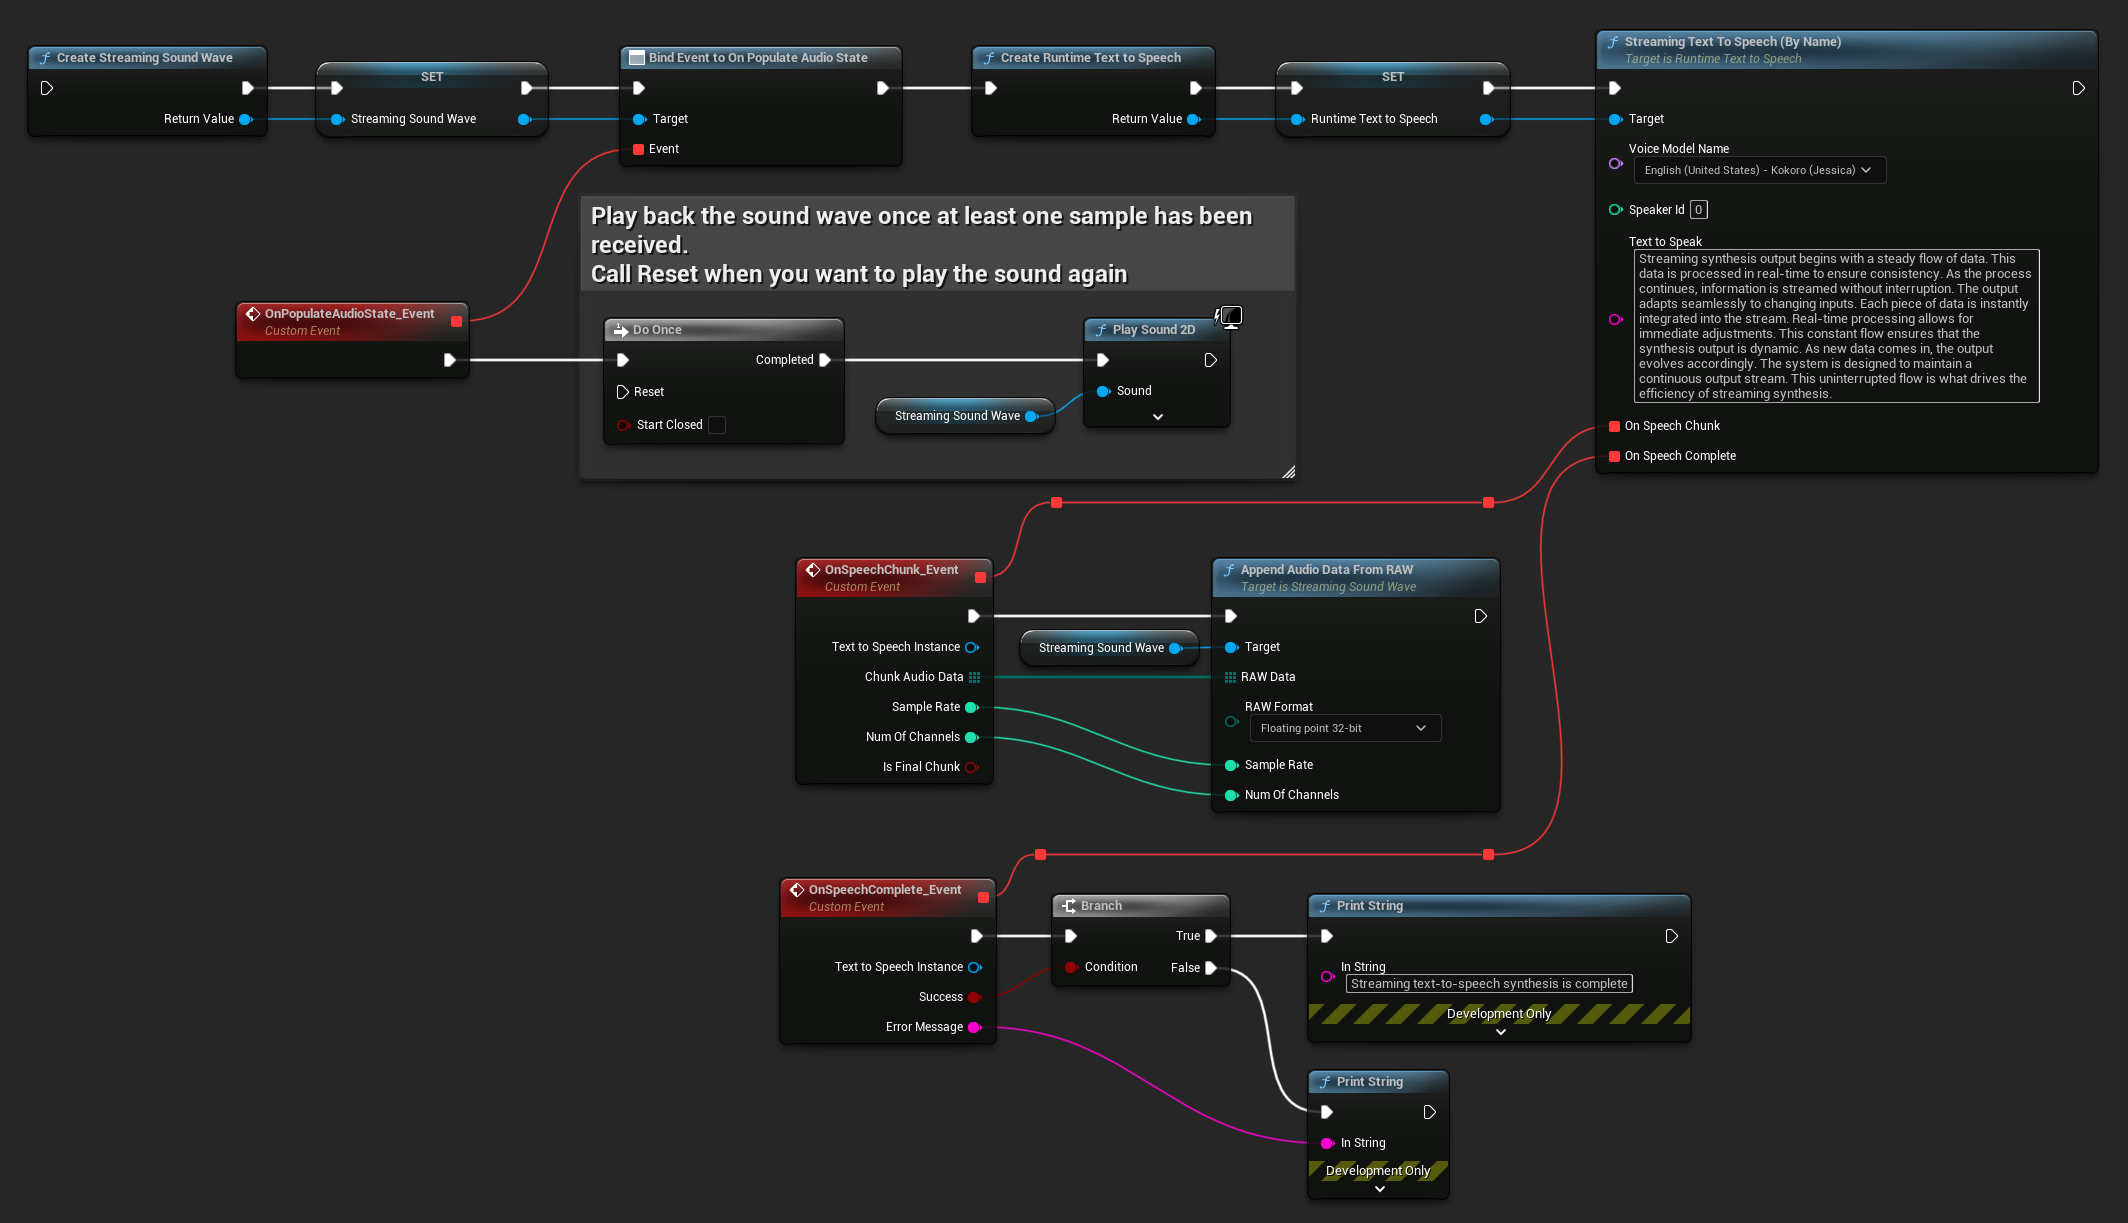
以下是如何在 C++ 中实现流式文本转语音与实时播放的示例:
        UPROPERTY()
        URuntimeTextToSpeech* Synthesizer;

        UPROPERTY()
        UStreamingSoundWave* StreamingSoundWave;

        UPROPERTY()
        bool bIsPlaying = false;

        void StartStreamingTTS()
        {
            // Create synthesizer if not already created
            if (!Synthesizer)
            {
                Synthesizer = URuntimeTextToSpeech::CreateRuntimeTextToSpeech();
            }

            // Create a sound wave for streaming if not already created
            if (!StreamingSoundWave)
            {
                StreamingSoundWave = UStreamingSoundWave::CreateStreamingSoundWave();
                StreamingSoundWave->OnPopulateAudioStateNative.AddWeakLambda(this, [this]()
                {
                    if (!bIsPlaying)
                    {
                        bIsPlaying = true;
                        UGameplayStatics::PlaySound2D(GetWorld(), StreamingSoundWave);
                    }
                });
            }

            TArray<FName> DownloadedVoiceNames = URuntimeTTSLibrary::GetDownloadedVoiceModelNames();

            // If there are downloaded voice models, use the first one to synthesize text, for example
            if (DownloadedVoiceNames.Num() > 0)
            {
                const FName& VoiceName = DownloadedVoiceNames[0]; // Select the first available voice model

                Synthesizer->StreamingTextToSpeechByName(
                    VoiceName,
                    0,
                    TEXT("Streaming synthesis output begins with a steady flow of data. This data is processed in real-time to ensure consistency. As the process continues, information is streamed without interruption. The output adapts seamlessly to changing inputs. Each piece of data is instantly integrated into the stream. Real-time processing allows for immediate adjustments. This constant flow ensures that the synthesis output is dynamic. As new data comes in, the output evolves accordingly. The system is designed to maintain a continuous output stream. This uninterrupted flow is what drives the efficiency of streaming synthesis."),
                    FOnTTSStreamingChunkDelegateFast::CreateWeakLambda(this, [this](URuntimeTextToSpeech* TextToSpeechInstance, const TArray<uint8>& ChunkAudioData, int32 SampleRate, int32 NumOfChannels, bool bIsFinalChunk)
                    {
                        StreamingSoundWave->AppendAudioDataFromRAW(ChunkAudioData, ERuntimeRAWAudioFormat::Float32, SampleRate, NumOfChannels);
                    }),
                    FOnTTSStreamingCompleteDelegateFast::CreateWeakLambda(this, [this](URuntimeTextToSpeech* TextToSpeechInstance, bool bSuccess, const FString& ErrorMessage)
                    {
                        if (bSuccess)
                        {
                            UE_LOG(LogTemp, Log, TEXT("Streaming text-to-speech synthesis is complete"));
                        }
                        else
                        {
                            UE_LOG(LogTemp, Error, TEXT("Streaming synthesis failed: %s"), *ErrorMessage);
                        }
                    })
                );
            }
        }
取消文本转语音
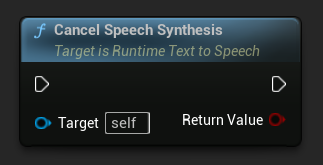
你可以随时通过在你的合成器实例上调用 CancelSpeechSynthesis 函数来取消正在进行的文本转语音合成操作:
- Blueprint
- C++
    // Assuming "Synthesizer" is a valid URuntimeTextToSpeech instance

    // Start a long synthesis operation
    Synthesizer->TextToSpeechByName(VoiceName, 0, TEXT("Very long text..."), ...);

    // Later, if you need to cancel it:
    bool bWasCancelled = Synthesizer->CancelSpeechSynthesis();

    if (bWasCancelled)
    {
        UE_LOG(LogTemp, Log, TEXT("Successfully cancelled ongoing synthesis"));
    }
    else
    {
        UE_LOG(LogTemp, Log, TEXT("No synthesis was in progress to cancel"));
    }
当合成被取消时:
- 合成过程将尽快停止
- 任何正在进行的回调将被终止
- 完成委托将被调用,参数为
bSuccess = false以及一条指示合成已取消的错误消息 - 为合成分配的任何资源都将被正确清理
这对于长文本或需要中断播放以开始新合成的情况特别有用。
说话人选择
两个 Text To Speech 函数都接受一个可选的说话人 ID 参数,这在处理支持多个说话人的语音模型时非常有用。您可以使用 GetSpeakerCountFromVoiceModel 或 GetSpeakerCountFromModelName 函数来检查您选择的语音模型是否支持多个说话人。如果有多个说话人可用,只需在调用 Text To Speech 函数时指定您想要的说话人 ID 即可。一些语音模型提供了广泛的选择——例如,English LibriTTS 包含超过 900 个不同的说话人可供选择。
Runtime Audio Importer 插件还提供了其他功能,例如将音频数据导出到文件、将其传递给 SoundCue、MetaSound 等等。有关更多详细信息,请查看 Runtime Audio Importer 文档。